面壁开源 MiniCPM-V 4.7:苹果手机 3GB 内存跑35B-A3B MoE
OpenBMB 发布并开源 MiniCPM-V 4.7,提供 35B-A3B 和 1B 两种规格,聚焦端侧多模态能力与推理效率。其中,35B-A3B 是 MiniCPM-V 系列首个 MoE 模型,可在 iPhone 17 Pro Max 上以仅 3 GB 内存实现 13+ token/s 的解码速度。
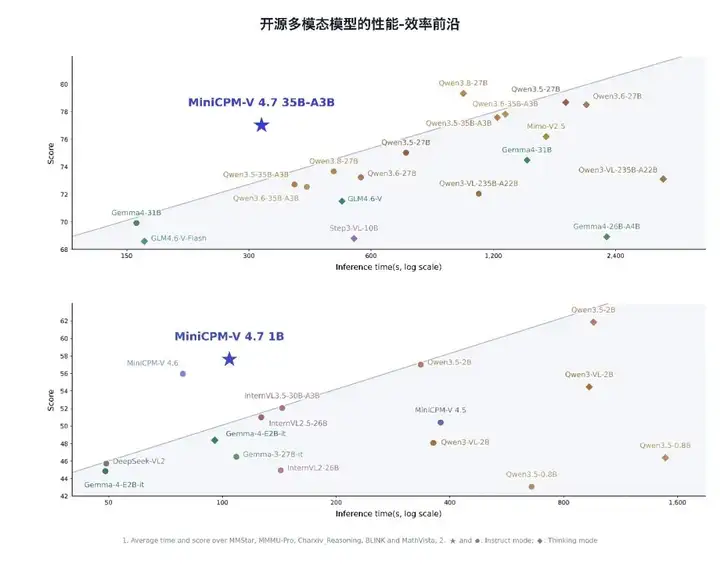
MiniCPM-V 4.7 的 35B-A3B 与 1B 同时刷新了性能—效率帕累托前沿。Instruct 模式下,35B-A3B 以更短的推理时间超过 Qwen3.6 35B-A3B,1B 在综合得分和推理效率上均显著领先 Qwen3.5 0.8B。
开源地址:
- 模型链接(35BA3B)
https://modelscope.cn/models/OpenBMB/MiniCPM-V-4.7-35B-A3B - 模型链接(1B)
https://modelscope.cn/models/OpenBMB/MiniCPM-V-4.7-1B - 代码仓库:
https://github.com/OpenBMB/MiniCPM-V
完整性能评估
35B-A3B:视觉语言与纯语言能力
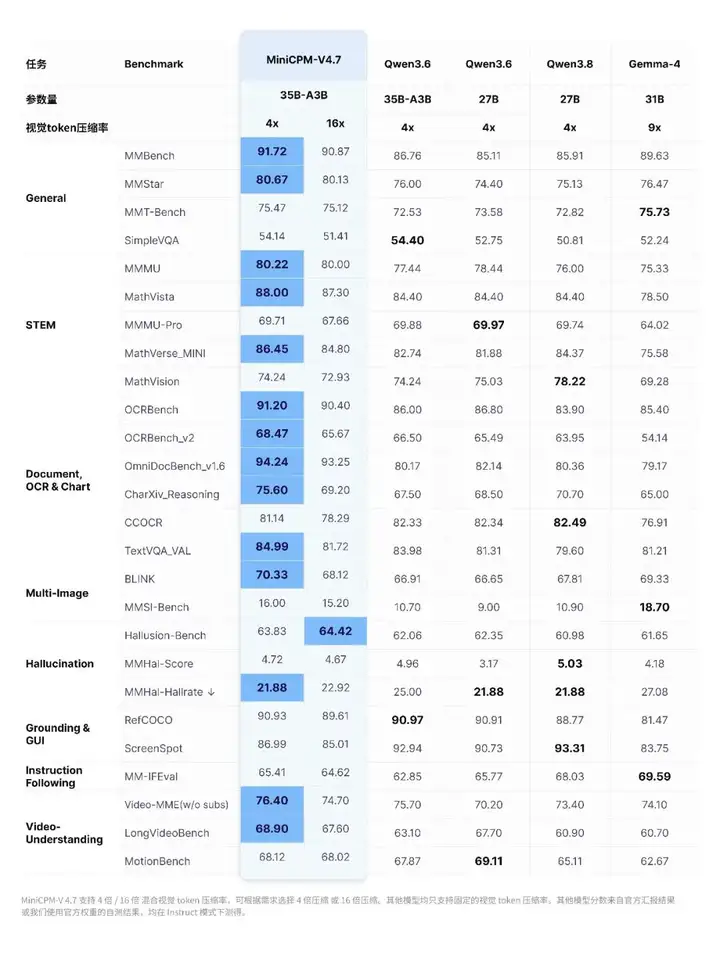
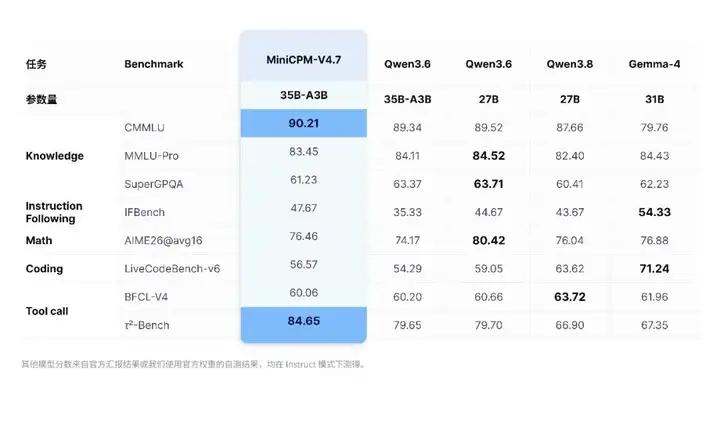
OpenBMB 给出了 35B-A3B 在 Instruct 模式下的视觉语言与纯语言评测结果。视觉语言部分覆盖综合多模态理解能力,语言部分用于观察 MoE 模型在通用语言任务上的表现。
视觉语言能力
纯语言能力:
1B:小参数端侧模型的完整评测
1B 版本面向更严格的端侧资源约束。相较 MiniCPM-V 4.6 继续提升基础能力,并在性能与推理耗时之间取得更高的能力密度。
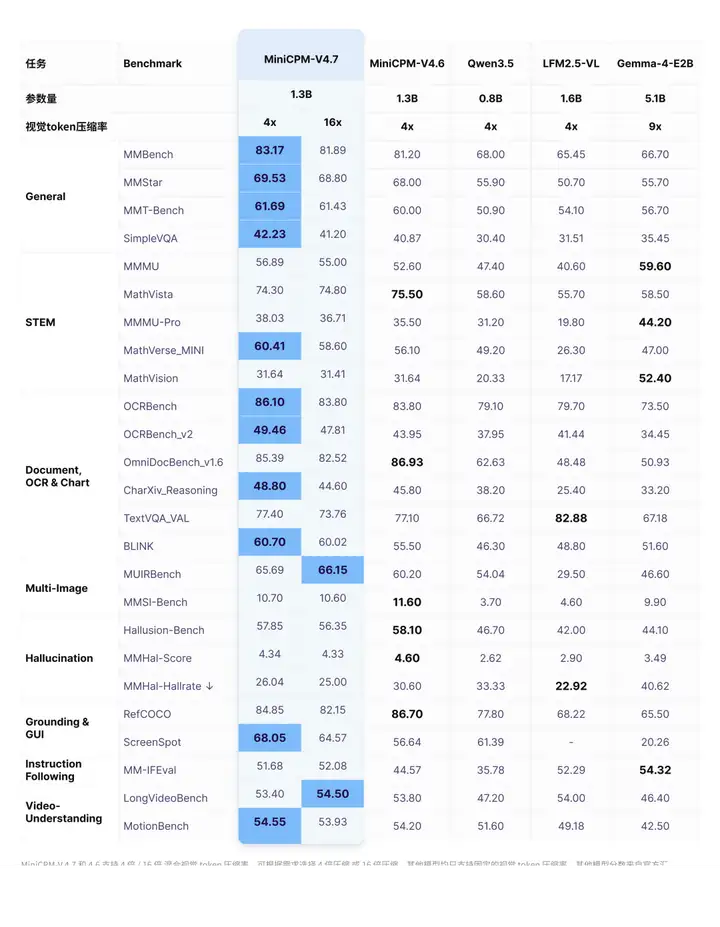
端侧能力与效率
无损且流畅的 MoE 端侧推理
MoE 的总参数量可以远大于单个 token 的激活参数量,但端侧设备仍需处理全部专家权重的存储与调度。不同 token 在不同层可能选择不同专家,设备内存通常无法同时容纳所有权重;若把权重保存在 SSD 中并按需加载,频繁读写又会带来明显等待,难以满足实时交互。
固定整段 prompt 的专家子集虽然可以降低加载频率,却会限制后续 token 的动态路由,可能排除模型原本会选择的专家。MiniCPM-V 4.7 35BA3B 的目标是同时解决这两个问题:不改变模型原有路由结果,同时减少有限内存与带宽下的加载等待。
具体方案由三项技术协同组成:
- LES(前瞻专家调度) 利用跨层路由预测,提前加载下一层可能用到的专家。预测只负责预取和调度,实际计算仍遵循模型原有的 token 级路由;未命中的专家也会正常加载并参与计算。
- 精细的层级量化 降低专家权重的存储占用和访存开销,使专家加载更适合端侧内存与带宽条件,同时保持模型能力。
- DSpark 投机采样适配 将投机采样与端侧推理流程结合,与专家调度和量化协同提升解码效率。
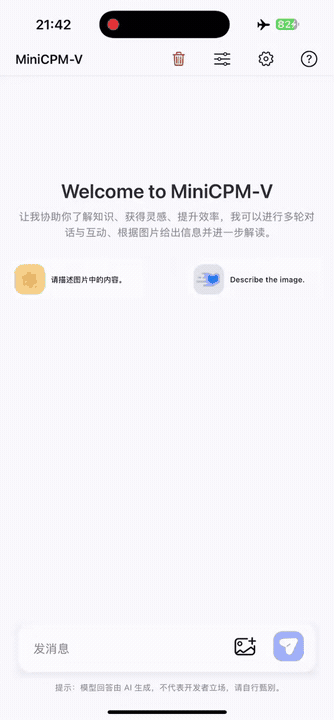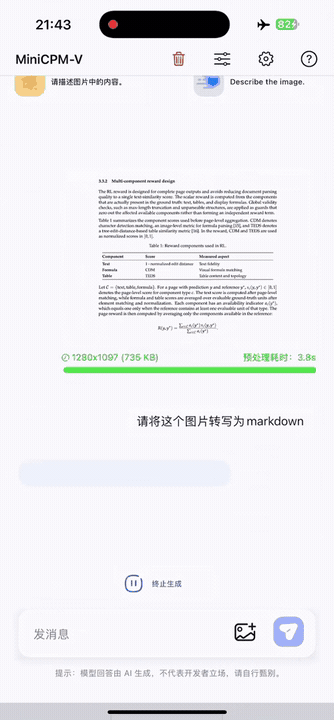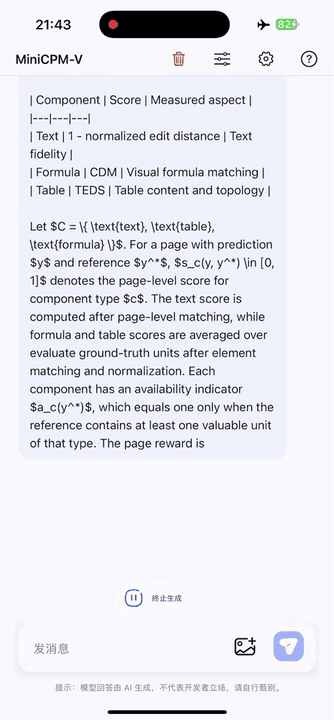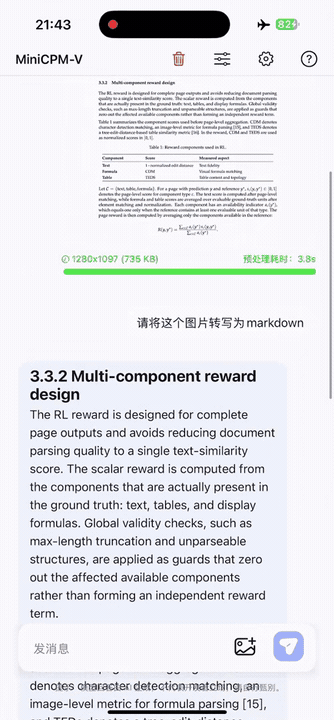
这套方案使 35B-A3B 在 iPhone 17 Pro Max 上仅占用 3 GB 内存,即可达到 13+ token/s 的解码速度。
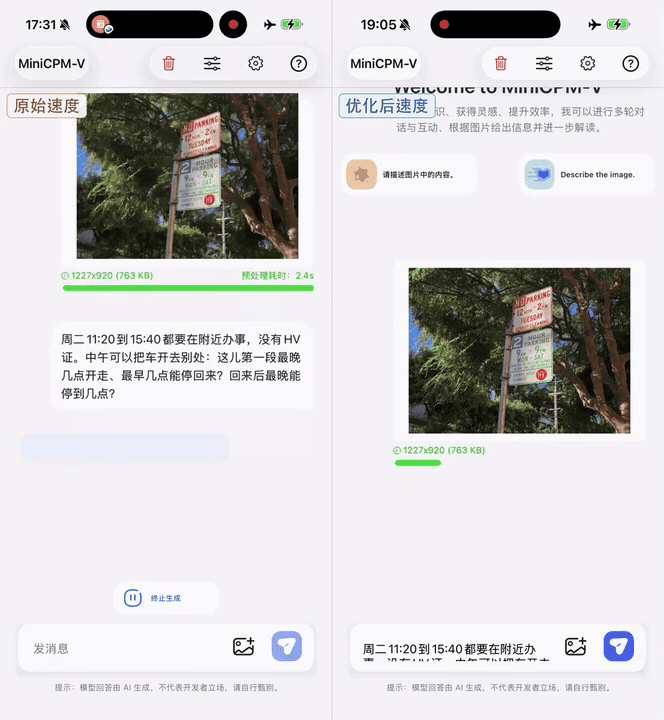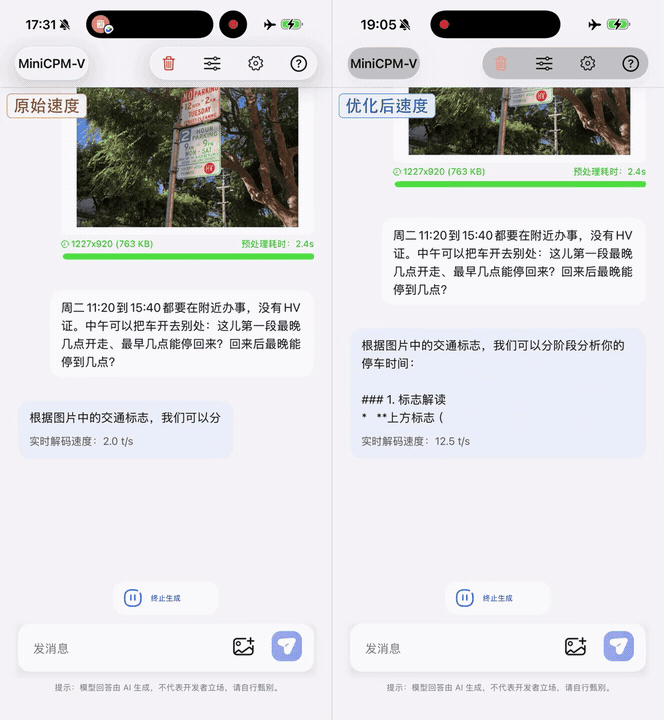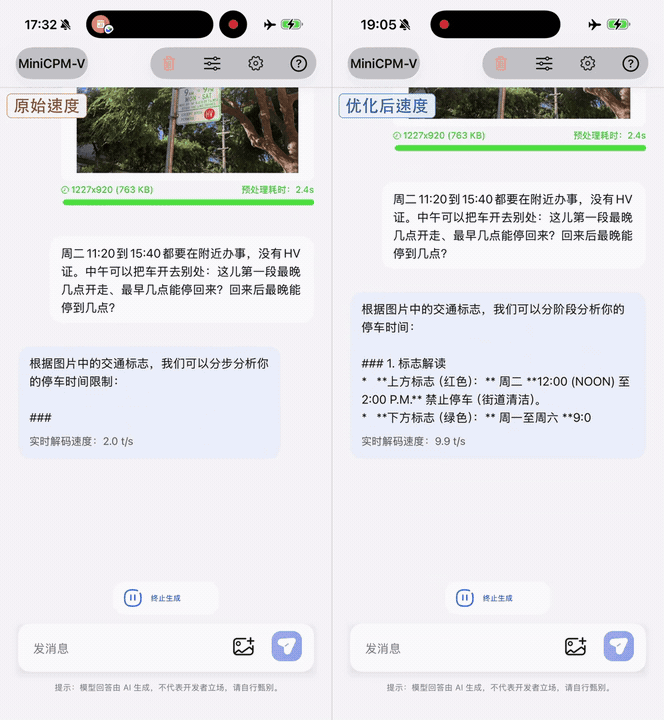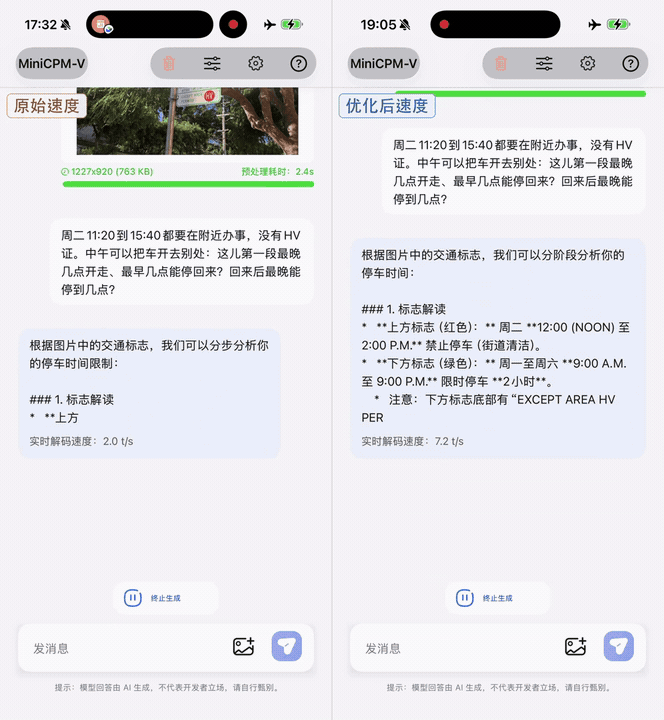
典型示例:
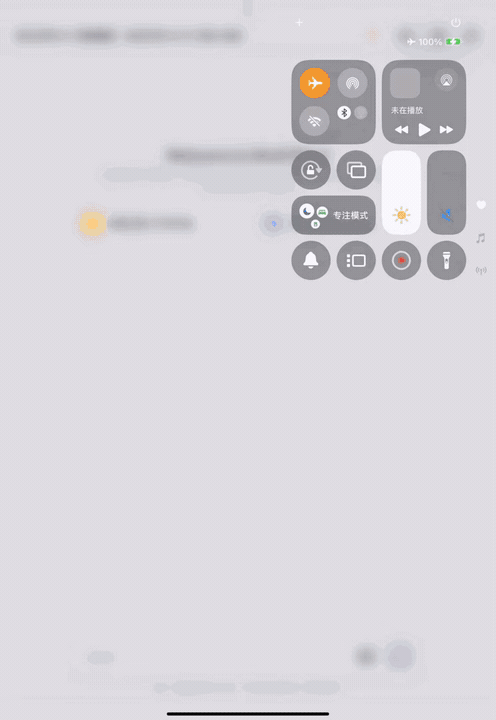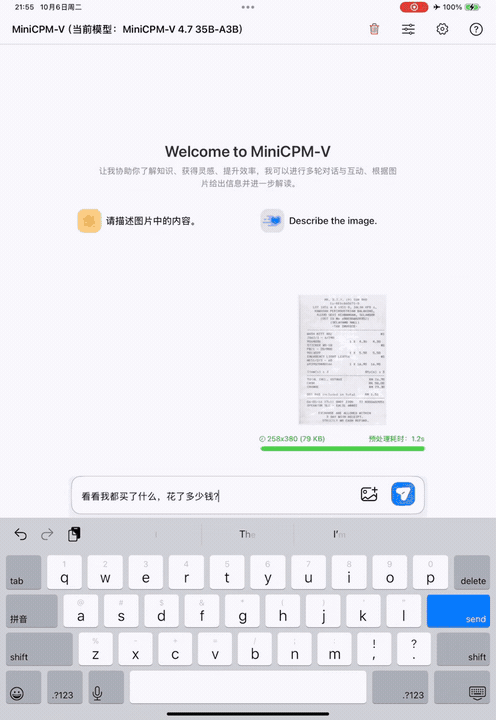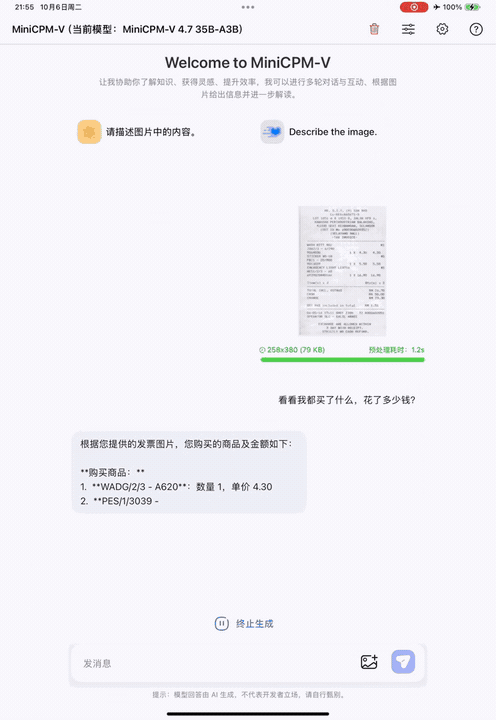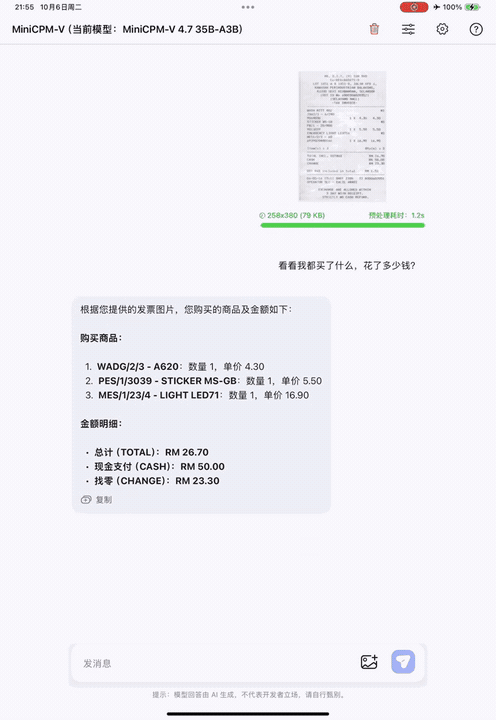
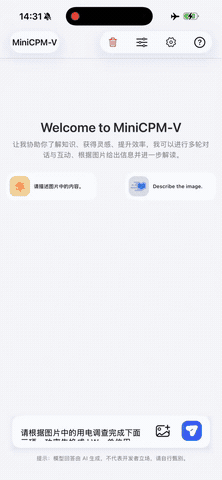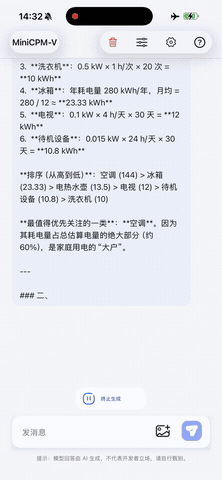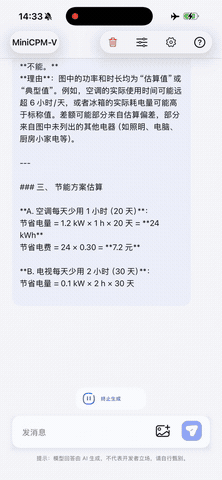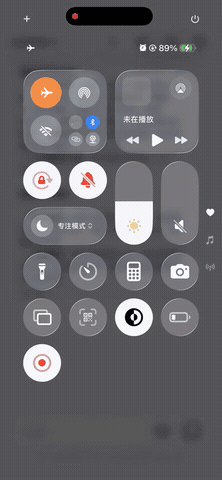
MiniCPM-V 4.7 可部署到手机和平板。以下三段素材均为原文提供的设备端未经剪辑屏幕录制,分别展示 35B-A3B 与 1B 在不同设备上的运行效果。
35B-A3B 在 iPhone 17 Pro Max 上运行:
35B-A3B 在 iPad M4 上运行
1B 在 iPhone 17 Pro Max 上运行
本地推理
模型下载
以下命令将 35B-A3B 下载到本地目录;如需 1B 版本,将模型 ID 替换为 OpenBMB/MiniCPM-V-4.7-1B。
modelscope download --model OpenBMB/MiniCPM-V-4.7-35B-A3B \
  --local_dir ./MiniCPM-V-4.7-35B-A3B
通过 Tranformers 推理
环境安装:
pip install "transformers[torch]>=5.18.0" torchvision torchcodec
推理脚本:
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "openbmb/MiniCPM-V-4.7-35B-A3B"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForImageTextToText.from_pretrained(
    model_id, torch_dtype="auto", device_map="auto"
)
# 推荐使用 Flash Attention 2 以获得更好的加速与显存节省,
# 尤其在多图和视频场景下效果显著。
# model = AutoModelForImageTextToText.from_pretrained(
#     model_id,
#     torch_dtype=torch.bfloat16,
#     attn_implementation="flash_attention_2",
#     device_map="auto",
# )
图片推理:
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "https://huggingface.co/datasets/openbmb/DemoCase/resolve/main/refract.png"},
            {"type": "text", "text": "What causes this phenomenon?"},
        ],
    }
]
downsample_mode = "16x"  # Using `downsample_mode="4x"` for Finer Detail
inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
    downsample_mode=downsample_mode,
    max_slice_nums=36,
    enable_thinking=False,
).to(model.device)
generated_ids = model.generate(**inputs, downsample_mode=downsample_mode, max_new_tokens=512)
generated_ids_trimmed = [
    out_ids[len(in_ids):] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text[0])
视频推理:
messages = [
    {
        "role": "user",
        "content": [
            {"type": "video", "url": "https://huggingface.co/datasets/openbmb/DemoCase/resolve/main/football.mp4"},
            {"type": "text", "text": "Describe this video in detail. Follow the timeline and focus on on-screen text, interface changes, main actions, and scene changes."},
        ],
    }
]
downsample_mode = "16x"  # Using `downsample_mode="4x"` for Finer Detail
inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
    downsample_mode=downsample_mode,
    max_num_frames=128,
    stack_frames=1,
    max_slice_nums=1,
    use_image_id=False,
    enable_thinking=False,
).to(model.device)
generated_ids = model.generate(**inputs, downsample_mode=downsample_mode, max_new_tokens=2048)
generated_ids_trimmed = [
    out_ids[len(in_ids):] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text[0])
模型微调
ms-swift 支持使用对 MiniCPM-V-4.7-1B / 35B-A3B 进行训练。ms-swift 是魔搭社区官方提供的大模型训练框架,开源地址:https://github.com/modelscope/ms-swift
环境准备:
pip install git+https://github.com/modelscope/ms-swift.git
pip install "transformers>=5.18.0" -U
# 更多依赖安装参考: https://swift.readthedocs.io/zh-cn/latest/Instruction/安装.html
多模态 SFT 脚本如下
# 16GiB
CUDA_VISIBLE_DEVICES=0 \
swift sft \
--model OpenBMB/MiniCPM-V-4.7-1B \
--dataset 'AI-ModelScope/LaTeX_OCR:human_handwrite
#2000
' \
--load_from_cache_file true \
--tuner_type full \
--torch_dtype bfloat16 \
--attn_impl sdpa \
--max_length 2048 \
--num_train_epochs 2 \
--per_device_train_batch_size 8 \
--gradient_accumulation_steps 1 \
--learning_rate 1e-5 \
--lr_scheduler_type cosine \
--split_dataset_ratio 0 \
--logging_steps 1 \
--save_steps 100 \
--dataset_num_proc 4 \
--dataloader_num_workers 4 \
--output_dir output
训练后对验证集进行推理:
CUDA_VISIBLE_DEVICES=0 swift infer \
--model output/vx-xxx/checkpoint-xxx \
--val_dataset latex_test3.jsonl \
--max_new_tokens 256 \
--temperature 0 \
--attn_impl sdpa \
--stream false
推送微调后的模型到ModelScope:
swift export \
  --adapters output/vx-xxx/checkpoint-xxx \
  --push_to_hub true \
  --hub_model_id '<your-model-id>' \
  --hub_token '<your-sdk-token>'
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1108条内容

所有评论(0)