Iris-3B开源:无VAE的文生图架构,支持深度估计与4倍超分
Speridlabs 正式开源 Iris-3B,这是一个 3B 参数的像素空间图像生成模型:不经过 VAE 压缩与解码,直接生成 RGB 像素,支持约 100 万像素的多种宽高比图像。它可按提示词生成摄影、插画和设计素材;同一骨干网络分别微调后,还可实现单目深度估计、图像修复与 4 倍超分辨率。
文生图基座、深度模型和修复/超分模型的权重及代码均以 Apache 2.0 协议开放。3B 参数指图像生成网络,文生图另需冻结的 Qwen3-VL-4B-Instruct 文本编码器。
开源地址:
- 模型链接
https://modelscope.cn/models/speridlabs/iris-3b - 代码仓库
https://github.com/speridlabs/iris-3b - 技术博客
https://speridlabs.com/research/iris - 论文链接
https://arxiv.org/pdf/2610.09450
性能表现:3B 像素空间模型的生成与视觉能力
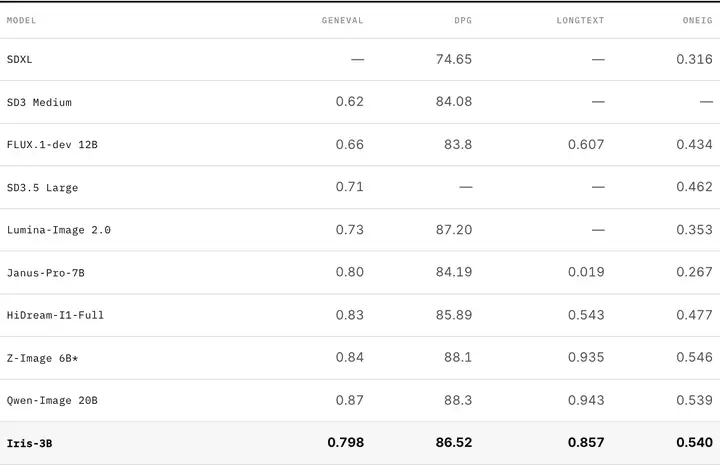
Iris-3B 在 OneIG-EN(英文整体分数)上得到 0.540,接近 Qwen-Image 20B ,在 GenEval、DPG 和 LongText 上则仍低于 Qwen-Image。
效果展示:从文生图到深度与画质修复
人像与时尚摄影
比如,生成带有串珠首饰和皮肤纹理的马赛族长者肖像,或沙漠中白裙随风展开的时尚摄影。前者呈现面部与织物细节,后者展示人物、布料和环境光的组合。
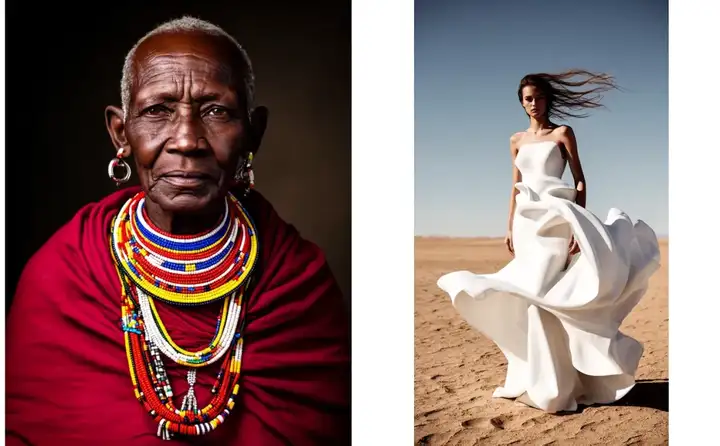
图片:马赛族长者肖像与沙漠时尚摄影
自然景观与微距
比如,描绘阳光穿过狭缝、照亮红色砂岩的峡谷,或停在叶片上的跳蛛微距。两张图分别展示岩壁层次与微小主体的毛发、眼睛和景深。
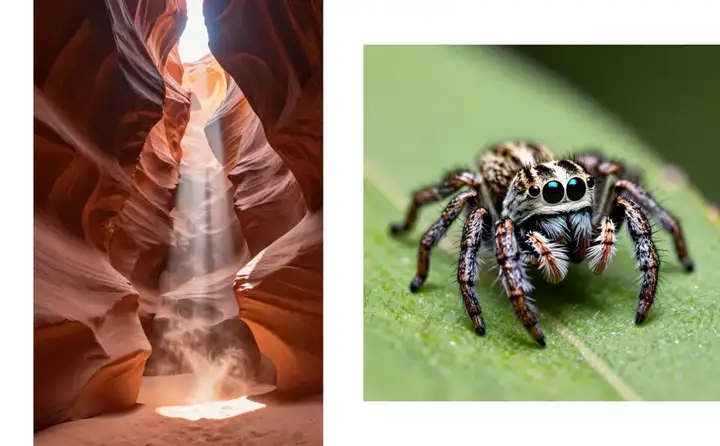
图片:砂岩峡谷与跳蛛微距
水彩与植物插画
比如,把撑伞行人的巴黎雨天街道画成水彩,或者绘制带有野玫瑰、蕨类和蝴蝶的植物插画。案例保留了水彩渗色、路面反射与纸张质感。
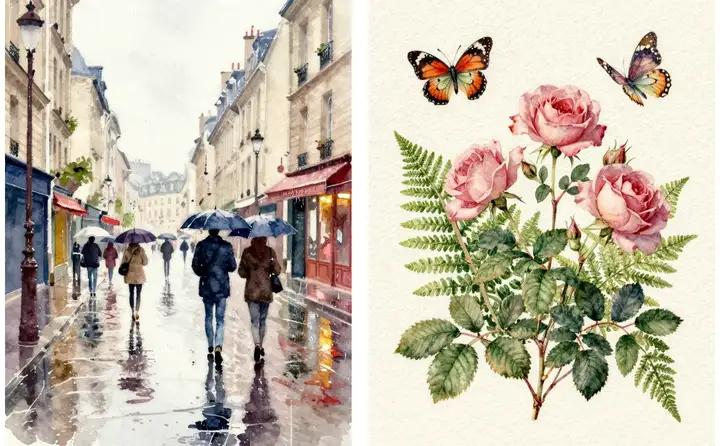
图片:巴黎雨街水彩与植物插画
微缩场景与 3D 风格
比如,在玻璃瓶中构建灯塔、岩岛和海浪组成的微缩景观,或生成等距视角的巫师书房,包含悬浮书籍、药水和发光水晶球。
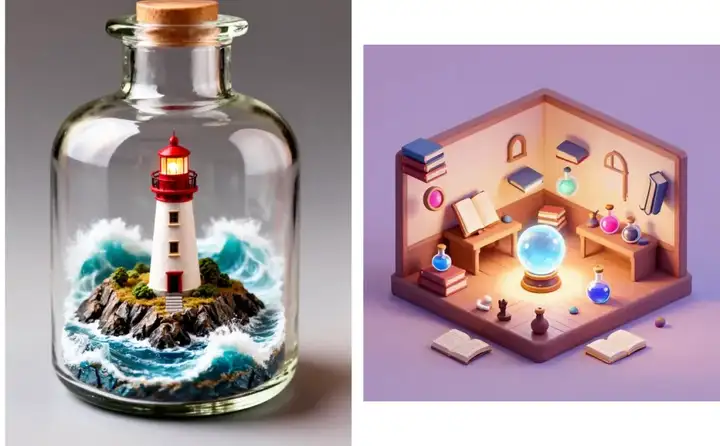
图片:瓶中灯塔与巫师书房
彩色玻璃与马赛克
比如,用彩色玻璃表现从火焰中升起的凤凰,或用金色、青绿色小瓷砖拼出拜占庭风格的孔雀。两张图展示了不同材料的分块结构与光泽。
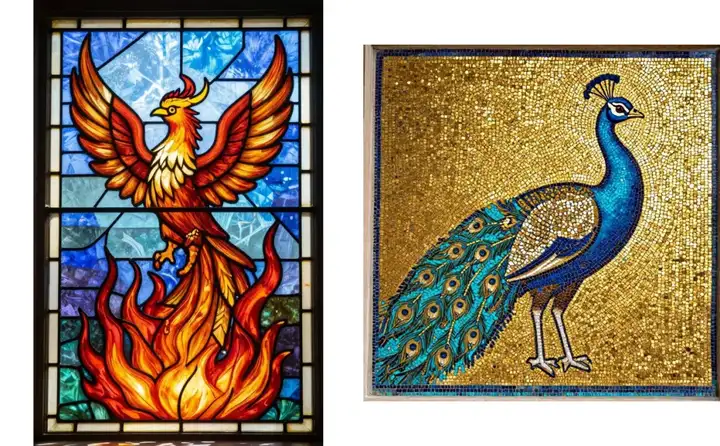
图片:凤凰彩色玻璃与孔雀马赛克
带文字的场景与海报
比如,在书店橱窗上写出“Books & Tea”,或生成带有“VISIT THE MOON”标题、火箭和月面景观的复古旅行海报。官方同时提醒,图像内文字和精确物体计数仍可能出错,不能把这些成功样例视为稳定性保证。
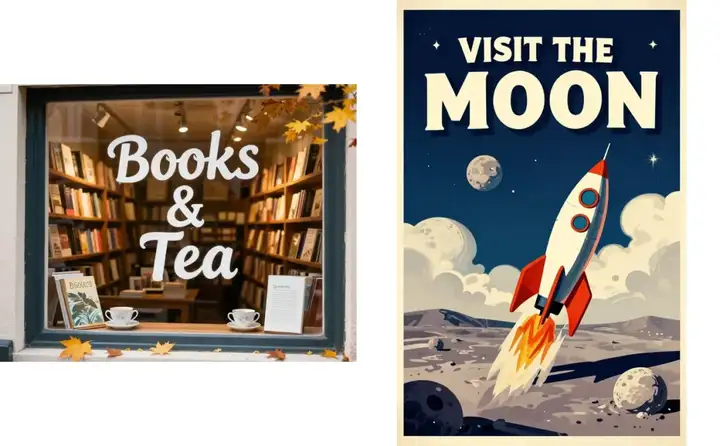
图片:书店橱窗与月球旅行海报
单目深度:一张图像预测相对远近
深度微调模型输入单张图像,输出相对深度图。下图包括两组客厅和一组浴室场景,左侧为输入图像,右侧为预测结果,展示家具、墙面和地面之间的远近关系。
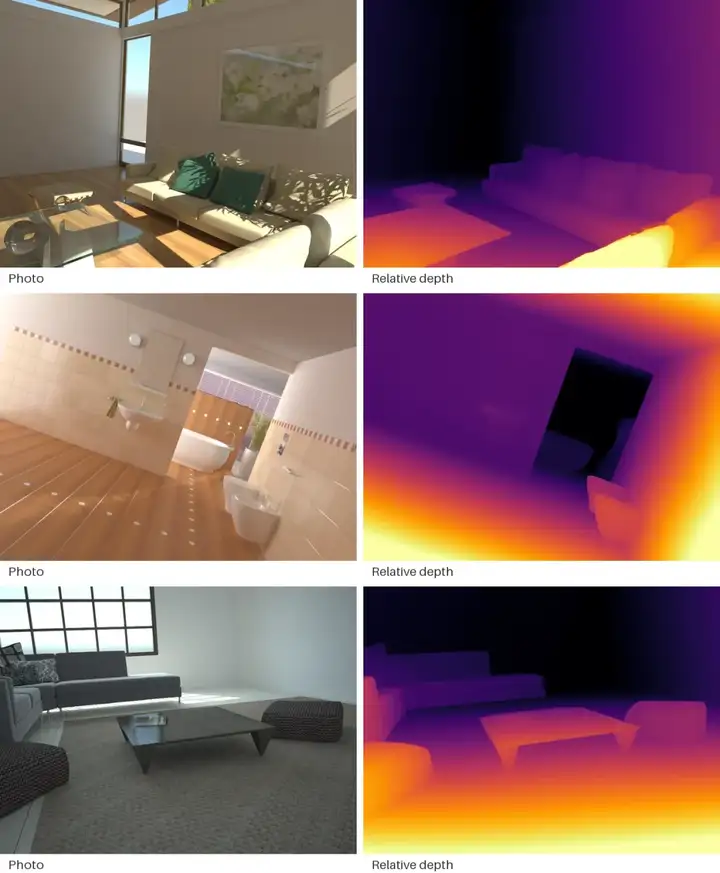
图片:三组室内场景的输入图像与相对深度对比
图像修复与超分:建筑、动物和人物
修复/超分微调模型接收退化图像,执行单步恢复与放大。比如,佛罗伦萨圣母百花大教堂的穹顶和立面、雪豹的胡须与斑纹,以及旧照片中的人物服饰,均有输入与输出对照。
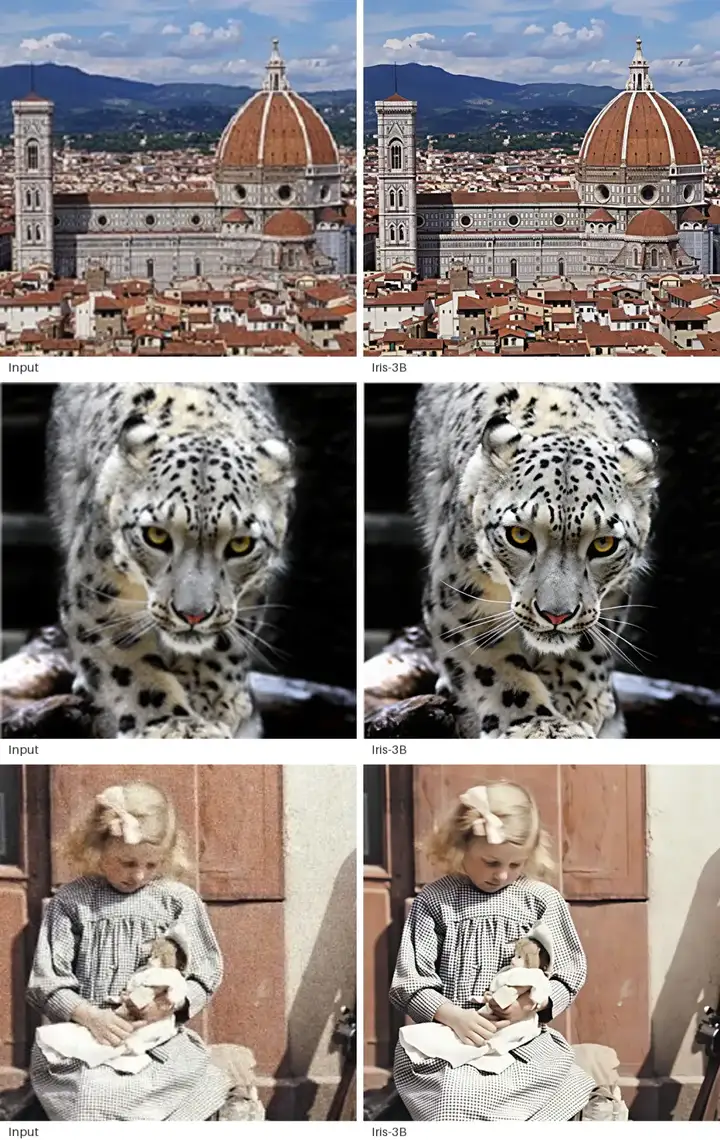
图片:佛罗伦萨建筑、雪豹、旧照片修复对比
更多案例包括古建筑的屋檐和砖墙,以及影视画面中的花饰、发型与衣物。左侧为退化输入,右侧为 Iris-3B 输出;恢复出的高频细节属于模型预测,不应等同于对原始真实纹理的精确还原。
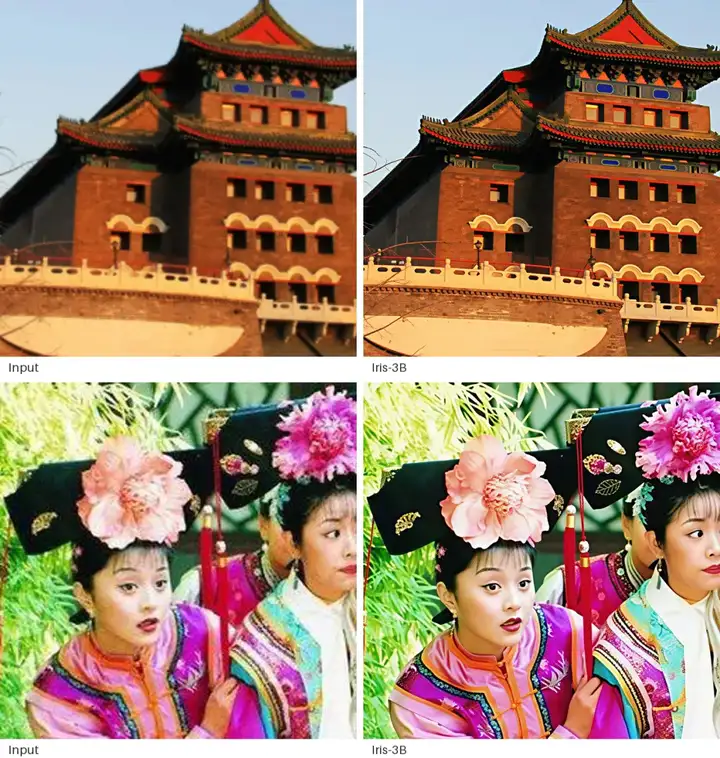
图片:古建筑与影视画面修复对比
架构:把语义理解与逐像素重建分开
无 VAE:不先压缩图像,再解码回来
多数扩散模型先用 VAE 将图像压缩为潜在表示,再在这个空间生成,最后解码为像素。Iris-3B 把生成过程直接放在像素空间,绕过 VAE 的有损压缩,以及潜在表示对纹理的偏向。可以理解为:不先把画面浓缩成一份“压缩草稿”,而是让模型直接学习如何画出像素;这不意味着生成结果没有误差,而是减少了独立压缩器这一环节的限制。
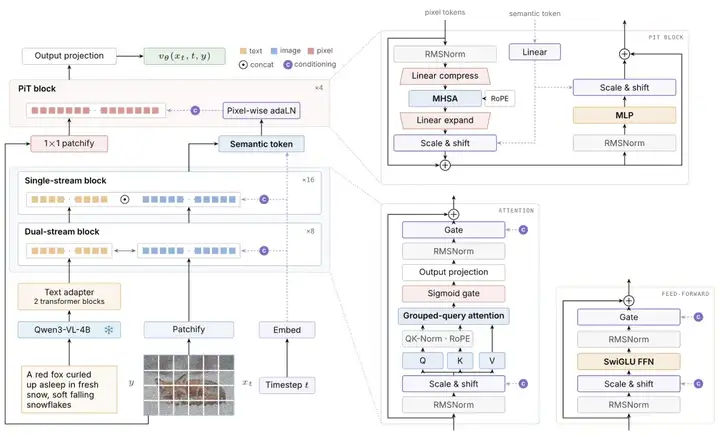
24 个主干块负责跨模态建模
图像先被切分成 16 × 16 像素图块。主干前 8 个双流块为文字和图像保留独立权重,再通过 16 个单流块联合处理两种 token。文字条件由冻结的 Qwen3-VL-4B-Instruct 提取,汇聚其 12 层隐藏状态,再经过包含 2 个 Transformer 块的文本适配器送入主干。2D RoPE 使同一套权重支持不同分辨率和宽高比,而不是只处理固定尺寸。
4 层 PiT 头负责预测像素流
主干学习图块层面的语义,末端的像素 Transformer(PiT)头接收当前带噪图像经 1 × 1 切分得到的像素 token,并以主干输出的图块语义 token 为条件。4 个 PiT 块通过逐像素自适应归一化引入语义条件,将像素特征压缩后进行跨图块注意力,再展开特征并输出 RGB 像素的流预测。这种分工把全局语义计算与高分辨率像素输出分开,避免所有主干层都直接处理百万像素序列。
生成先验迁移到密集视觉任务
深度模型和修复/超分模型沿用同一架构,但分别采用对应任务的权重。两者使用预先保存的空提示表示,采用单步预测,不需要文生图的多步采样,也无需运行文本编码器;修复大尺寸图像时,按 1024 × 1024 重叠窗口处理,每个窗口分别执行一次前向传播。
训练采用 Rectified Flow,从 256 像素开始,逐步提升到 512 和 1024 像素,再进行 1024 像素监督微调,总计 66.5 万步。其双层设计将图块级语义建模与像素级输出结合,深度与修复能力则来自后续各自的任务微调。
如何使用:从魔搭下载,在本地运行
官方代码要求 Python 3.11 及以上、PyTorch 2.7.1 及以上,以及支持 CUDA 与 bfloat16 的 NVIDIA GPU,并需预留充足主存和显存。文生图权重以 float32 EMA 格式保存,约 12 GB,CUDA 前向使用 bfloat16 自动混合精度;depth/ 和 upscaler/ 目录各额外约 12 GB。文生图还需下载独立的 4B 文本编码器。
安装环境
在已配置 CUDA 版 PyTorch 的 Python 3.11+ 环境中,获取官方代码并安装依赖。以下命令均在仓库根目录运行。
git clone https://github.com/speridlabs/iris-3b.git
cd iris-3b
python -m pip install -e .
从魔搭下载模型
完整下载 Iris 仓库会同时获取文生图基座、depth/ 和 upscaler/ 的任务权重。文生图还需完整下载 Qwen3-VL-4B-Instruct;若只使用深度或修复模型,可省略第二条命令。
modelscope download --model speridlabs/iris-3b \
  --local_dir ./checkpoints/iris-3b
modelscope download --model Qwen/Qwen3-VL-4B-Instruct \
  --local_dir ./checkpoints/Qwen3-VL-4B-Instruct
文生图
通过 --set 将文本编码器明确指向本地目录,无需修改源码。示例沿用官方推荐的朴素英文描述,输出 1024 × 1024 图像,采用 100 步、CFG 3 和固定种子。
python scripts/sample.py \
  --checkpoint ./checkpoints/iris-3b \
  --set text_encoder.pretrained=./checkpoints/Qwen3-VL-4B-Instruct \
  --prompt "a red fox sleeping in fresh snow, golden hour" \
  --height 1024 --width 1024 \
  --steps 100 --cfg-scale 3 --seed 0 \
  --outdir ./output/samples
单目深度
将 photo.jpg 替换为本地图像,--weights 指向 depth/,不会加载文本编码器。
python scripts/depth.py photo.jpg \
  --weights ./checkpoints/iris-3b/depth \
  --out ./output/depth
输出包括相对对数深度 .npy 和着色预览 .png。
图像修复与 4 倍超分
--weights 指向 upscaler/,输出文件名带 _x4.png 后缀。
python scripts/upscale.py photo.jpg \
  --weights ./checkpoints/iris-3b/upscaler \
  --out ./output/upscaled
默认先将大输入限制到短边不超过 512、长边不超过 1024 像素,再执行 4 倍放大。
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1107条内容

所有评论(0)