JEV-27B-VL 开源:多模态决策模型,Jev Decision Index 0.3 视觉榜单第一
AutoTrust AI Lab 开源 JEV-27B-VL,一款基于 Qwen3.8-27B 的多模态决策模型。它可以视为能“看见”的 JEV-27B:沿用原有的 System 1 决策与 System 2 推理能力,并将其扩展至图像输入。
System 1 可在单次前向传播中完成 yes/no 判断、2–256 个选项选择和 0–5 评分,并输出校准概率;System 2 则保留 Qwen3.8-27B 的通用多模态理解与推理能力。JEV-27B-VL 的决策头仅通过纯文本训练,即可零样本迁移至图像。
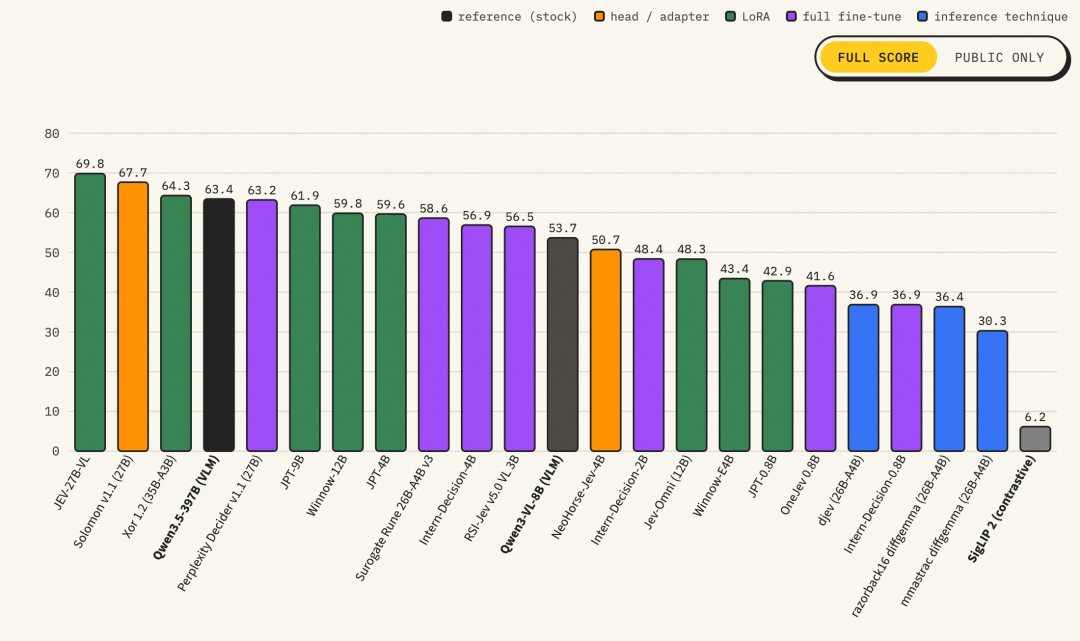
截至 2026 年 10 月 7 日,JEV-27B-VL 在 Jev Decision Index 0.3 视觉榜单的 20 个视觉决策模型中排名第一,并在 13,695 条评测数据上取得 77.8% 的准确率。模型支持最长 256K tokens 上下文,采用 Apache 2.0 协议开源。
开源地址:https://modelscope.cn/models/autotrust/JEV-27B-VL
效果展示
机械臂抓取与放置
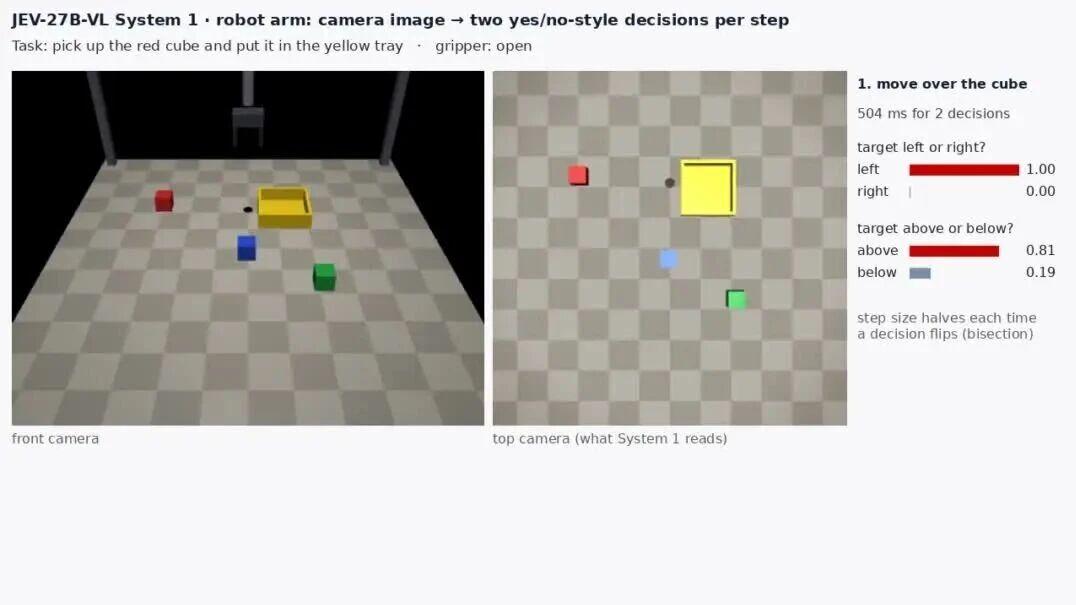
每一步都是一次 System 1 决策:输入顶部相机画面,分别判断目标位于夹爪左侧还是右侧、上方还是下方,再据此移动机械臂。
模型在 20 个随机场景中完成率为 75%,为 JEV 系列中的最佳表现。所有成功抓取的方块均被放入托盘(15/15);所有失败情况均为抓取位置偏离目标 3.0–3.7 厘米。每次决策耗时约 240 毫秒。
计算机操作
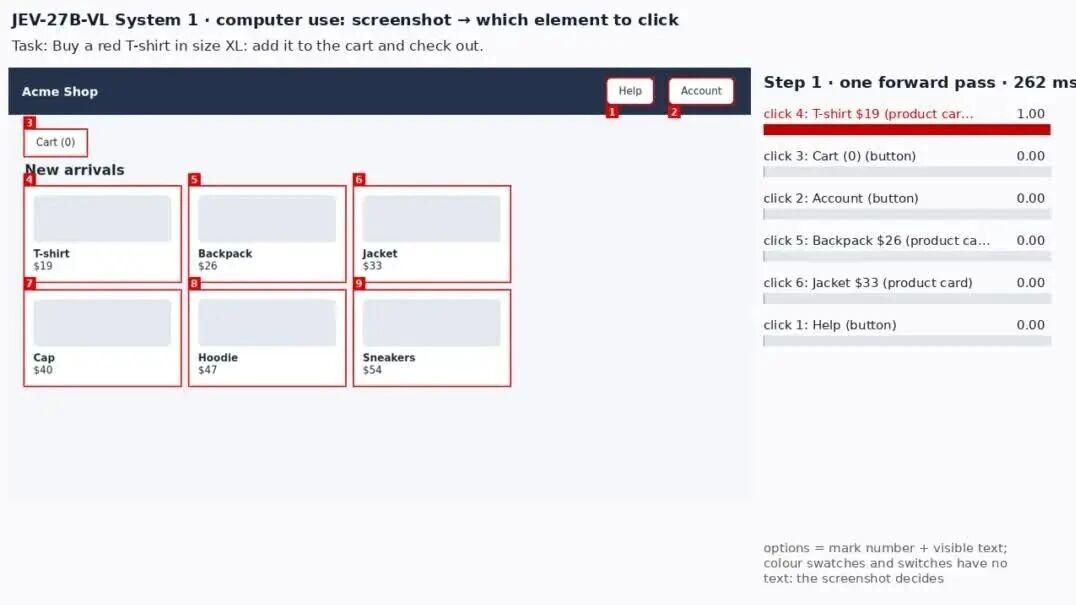
浏览器会为可点击元素标注编号,System 1 根据截图选择下一次点击,或判断任务已经完成。
在商店、设置和邮件三类 60 个随机多步任务中,结合编号框与元素文本时完成率为 95%,每项任务包含 3–7 次点击,每次点击决策约 0.26 秒。
颜色样本没有附带文本,因此对应点击完全由截图决定。
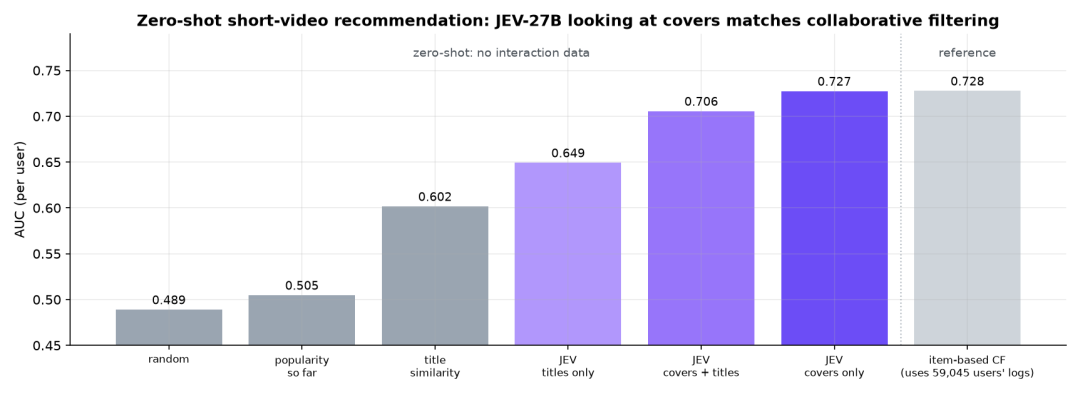
零样本短视频推荐
模型根据用户最近观看的 5 条视频封面和 1 条候选视频封面,在一次前向传播中返回用户观看候选视频的概率,不依赖交互日志、物品向量或额外训练。
在真实短视频平台公开MicroLens-100k 数据集上对 200 名用户进行离线评测,将每人实际接下来观看的视频隐藏在另外 19 个其他用户在 ±3 天内观看过的视频中(即信息流当时可能展示的内容),各方法对这 20 个候选视频进行排序。
仅使用封面时取得 0.727 AUC,与使用 59,045 名用户行为训练的物品协同过滤基本持平(0.728),Top-5 命中率则为 59% 对 49%。
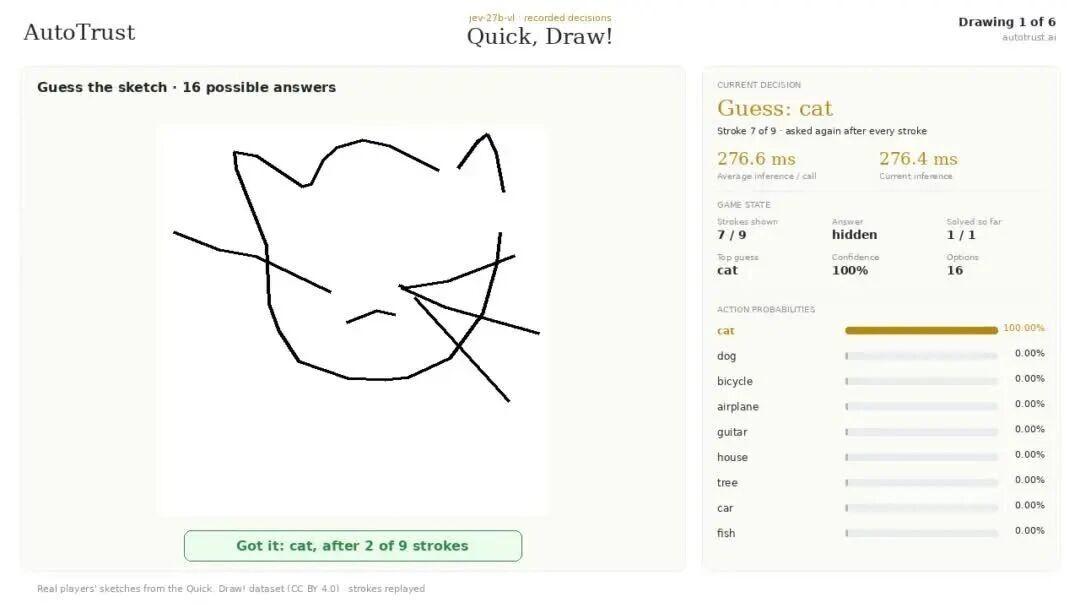
Quick, Draw! 草图识别
System 1 根据绘制过程逐笔判断图像属于 16 个候选类别中的哪一个。在 320 幅真实玩家草图上,完整绘制后识别准确率为 88%;仅绘制 60% 笔画时准确率为 62%,随机猜测为 6%,每次判断约 270 ms。
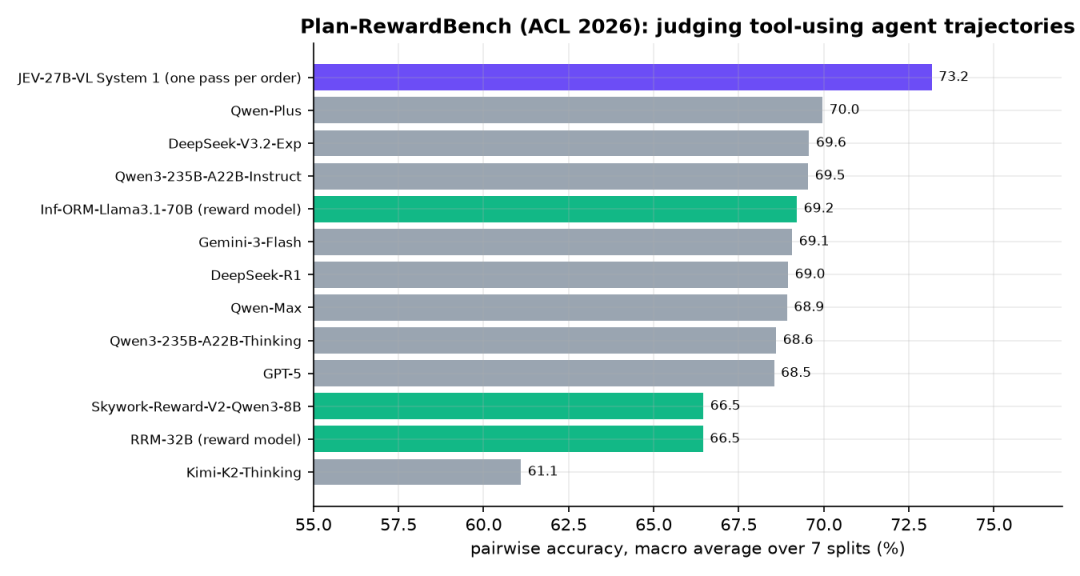
智能体任务评审
在 Plan-RewardBench(ACL 2026)上,模型需要从两条完整的工具型智能体轨迹中选出更优者,任务覆盖规划、错误恢复、安全拒答和工具无关性。
JEV-27B-VL System 1 在 1,171 对样本上的宏平均准确率为 73.2%!
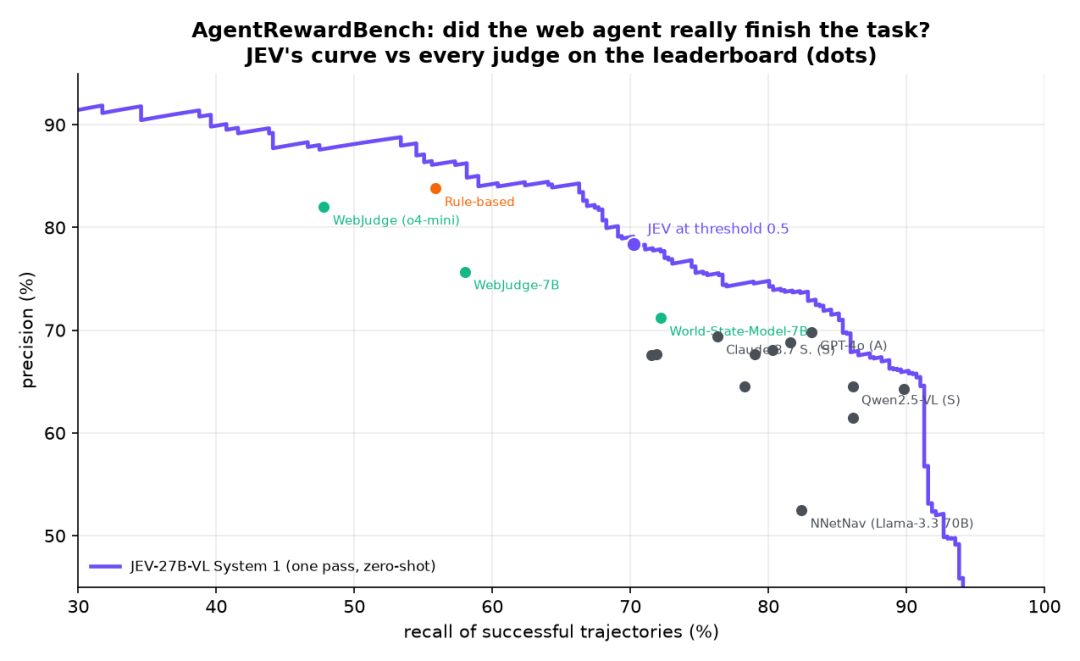
在 AgentRewardBench 的 1,302 条专家标注轨迹上,JEV-27B-VL 根据用户目标、智能体动作、最终回复和最终截图,零样本判断任务是否真正完成,其精确率 在每个评判器自身召回率水平下均高于官方排行榜上的所有评判器:
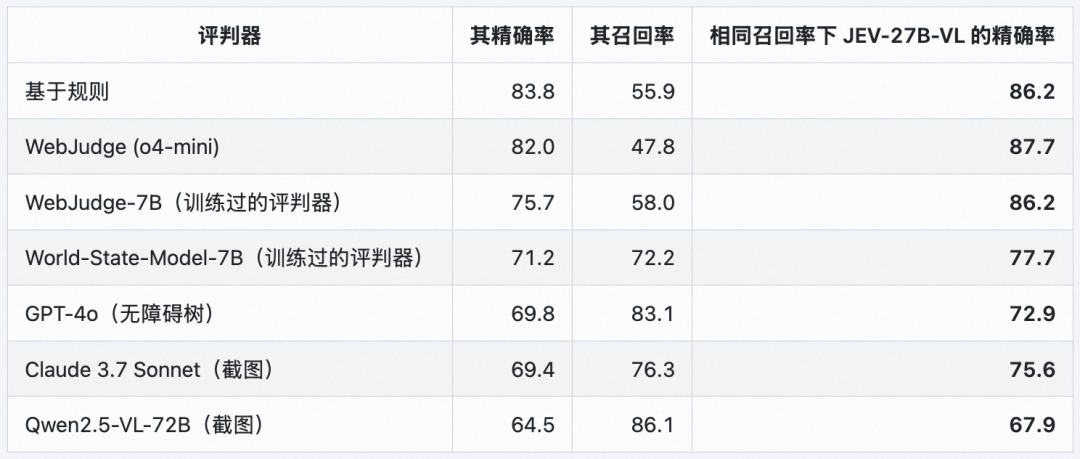
阈值设为 0.5 时,精确率为 78.4%、召回率为 70.2%,AUROC 为 0.91;全部判断在单张 GPU 上约 4 分钟完成。
多模态评审
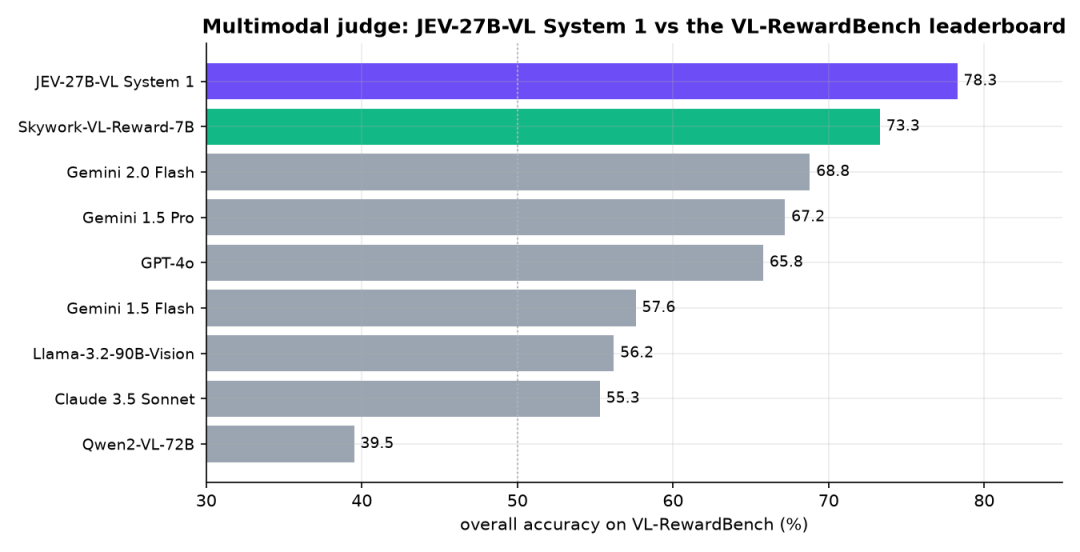
在 VL-RewardBench(CVPR 2025)的 1,247 对人工核验回答上,模型根据图像、问题和两个候选答案,零样本判断哪个答案更好,总体准确率为 78.3%,超过该基准官方排行榜上的所有模型。
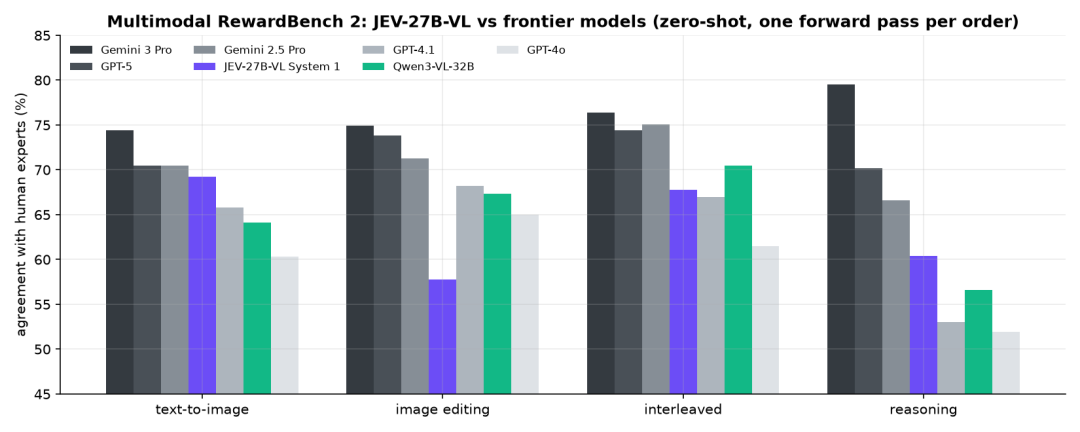
Multimodal RewardBench 2 的四项任务各含 1,000 对专家标注样本,任务分别是文生图、图像编辑、交错输入、推理得分。四项任务的平均分与 GPT-4.1 和 Qwen3-VL-32B 相当,GPT-5 和 Gemini 3 Pro 仍保持领先。
模型使用
环境与模型下载
默认启动配置使用 32K 上下文,建议准备一张 80 GB 或更大显存的 GPU。完整 256K 上下文需要额外 KV Cache;官方测试中,256K 提示在 183 GB B200 上运行,在 80 GB GPU 上建议先将最大长度设为 131072。
安装 ModelScope,并将模型下载到本地目录:
pip install -U modelscope
modelscope download --model autotrust/JEV-27B-VL --local_dir JEV-27B-VL
运行仓库内的启动脚本:
bash JEV-27B-VL/serve.sh
该脚本会在 8000 端口启动标准 vLLM OpenAI 服务,并额外提供 System 1 使用的 POST /v1/decide 接口。若需要自定义启动参数,可执行:
python3 JEV-27B-VL/serve_decide.py \
  --model JEV-27B-VL \
  --served-model-name autotrust/JEV-27B-VL \
  --enable-lora \
  --max-lora-rank 32 \
  --lora-modules jev-decision=JEV-27B-VL/adapter_vllm \
  --logprobs-mode processed_logprobs \
  --max-model-len 32768 \
  --enable-prefix-caching \
  --mamba-cache-mode align \
  --limit-mm-per-prompt '{"image": 8}' \
  --max-num-seqs 8 \
  --trust-request-chat-template
如需启用完整 256K 上下文,可在运行 serve.sh 前设置:
export MAX_MODEL_LEN=262144
bash JEV-27B-VL/serve.sh
System 1:输出可校准的决策概率
/v1/decide 接收 kind、state、question 和可选的 options。其中,noul 对应 yes/no,score 对应 0–5 评分,choice 支持 2–256 个候选项。
curl localhost:8000/v1/decide \
  -H 'Content-Type: application/json' \
  -d '{
    "kind": "choice",
    "state": "Customer: my card was charged twice for one coffee.",
    "question": "Which team should handle this?",
    "options": ["billing", "shipping", "tech support"]
  }'
接口会返回每个选项的概率、最高概率选项、token 用量与耗时。例如该请求会把 billing 作为首选,并返回约 0.9969 的概率。
图像决策时,将 state 写成文本与图片交替组成的列表。图片既可以使用 HTTPS URL,也可以使用 Base64 data URL:
import base64
import requests

def image(path):
    data = base64.b64encode(open(path, "rb").read()).decode()
    return {"image": "data:image/jpeg;base64," + data}

def decide(kind, state, question, options=None):
    body = {"kind": kind, "state": state, "question": question}
    if options:
        body["options"] = options
    result = requests.post(
        "http://localhost:8000/v1/decide", json=body
    ).json()
    return dict(zip(result["options"], result["probabilities"]))

print(decide(
    "noul",
    ["Photo: ", image("photo.jpg")],
    "Is this scenario one where: the image shows food or cooking?",
))
System 2:多模态理解与推理
System 2 通过标准 OpenAI 兼容接口调用,可关闭思考模式直接回答图像问题:
import base64
import requests

def image_url(path):
    data = base64.b64encode(open(path, "rb").read()).decode()
    return {
        "type": "image_url",
        "image_url": {"url": "data:image/png;base64," + data},
    }
result = requests.post(
    "http://localhost:8000/v1/chat/completions",
    json={
        "model": "autotrust/JEV-27B-VL",
        "messages": [{
            "role": "user",
            "content": [
                image_url("chart.png"),
                {"type": "text", "text": "What does this chart show?"},
            ],
        }],
        "max_tokens": 1024,
        "chat_template_kwargs": {"enable_thinking": False},
    },
).json()
print(result)
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1105条内容

所有评论(0)