至知创新研究院开源 IQuest-Q1:320B/15B MoE,NL2Repo 仅次于 Claude Opus 5
至知创新研究院开源 IQuest-Q1—— 一款定位于提升智能体 CLI 系统的基础能力的智能体基座模型。它采用稀疏 MoE 架构,总参数 320B、激活 15B,上下文 524,288 token;训练在合成环境中进行:任务与环境一并合成,同一策略在多种脚手架中训练(保留各脚手架原生的工具与上下文管理,只有策略自身的错误才作为学习信号),四个专家模型再由多教师在线策略蒸馏(MOPD)整合进同一学生模型,跨阶段融合为最终版本。
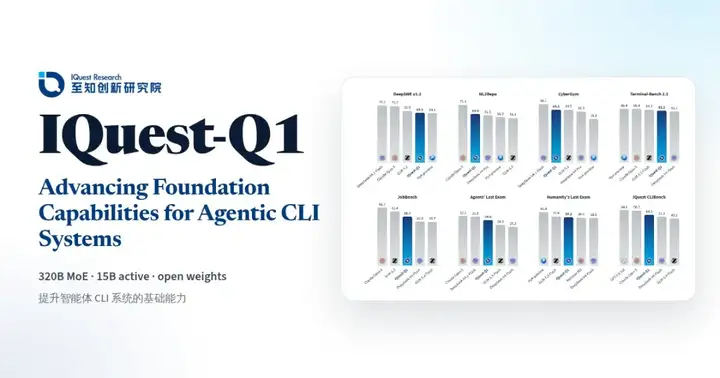
在官方对比的 8 项基准中,它 6 项进入前三:NL2Repo 63.0 仅次于 Claude Opus 5,CyberGym 84.5 与 GLM-5.3 并列第二。
● 模型下载:https://www.modelscope.cn/models/IQuestLab/IQuest-Q1
● GitHub:https://github.com/IQuestLab/IQuest-Q1
● 技术报告:https://iquestlab.github.io
效果案例
案例一:办公任务
IQuest-Q1 可以通过 lark-cli 在飞书中完整处理办公任务:核对聊天记录与文档,做出基于事实的判断,并完成文档、幻灯片、会议与通报等相关工作的后续交付。
在模拟的飞书环境中,澜川证券于 10 月 22 日反馈接口返回了其他客户的数据。模型扮演数据平台负责人,从三个飞书群、制度文档和云盘草稿中还原事件;各方说法不一,业务方还希望只处理澜川一家。
判断:它依据制度将事件定为 1 级(37,214 次跨客户读取),并判定须通知全部六家受影响客户,而不只是澜川一家。
交付:随后更新影响清单、安排复盘会,完成报告和六页管理层幻灯片,创建七项具名负责的整改任务,并以 11 条进度回执和进度看板记录执行过程。
排障:分派任务时遇到负责人 ID 无效,它查阅命令帮助,从群消息发送者建立姓名与 app_id 的对应关系,随后完成分派并回读确认。
案例二:修复多轮训练
IQuest-Q1 在 Claude Code 中排查奖励异常,发现是解码时多出的空格导致训练只计算了最后一轮对话的损失。
原因:额外插入的空格破坏了文本的前缀匹配,使得前几轮对话虽然还在上下文中,却被排除在了训练损失计算之外。
修复:关闭额外分隔空格,保留模型生成的空白字符,并确保流式文本与存储轨迹一致。
结果:多轮训练恢复,奖励均值随之回升。
案例三:修复任务执行环境
环境更新后,原本能完成的任务开始大量失败。IQuest-Q1 在 Claude Code 中排查任务执行与评分流程。
原因:依赖、测试启动与服务访问故障,使部分任务在补丁执行前就失败,并被计入模型的负奖励。
修复:修复环境并增加健康检查,将确认的基础设施故障排除出策略更新;模型自身的失败仍保留负奖励。
验证:用同一批任务与补丁复验评分恢复情况;评分恢复与模型能力提升分别判断。
案例四:搭建研发工作台
研究人员想使用 IQuest-Q1 搭建一个研发工作台,用来查看研发会话中的失败命令、日志、代码改动、测试和报告,并与对应代码版本绑定;随后在工作台上发起修复一个失败的导出任务。
原因:部分源文件的修改时间为 0(1970 年),而 Python 的 zipfile 不接受 1980 年之前的时间戳,导致评审包导出失败。
修复:只做最小改动——为归档设置 strict_timestamps=False,并补充一条混合新旧时间戳的回归测试;项目数据保持不变。
验证:工作台与项目测试全部通过;完整性报告确认归档中的所有文件齐全,且与源文件逐字节一致。
前端演示
IQuest-Q1 把文字需求写成可交互的网页,涵盖游戏、个人工具、设计与布局和科学可视化。
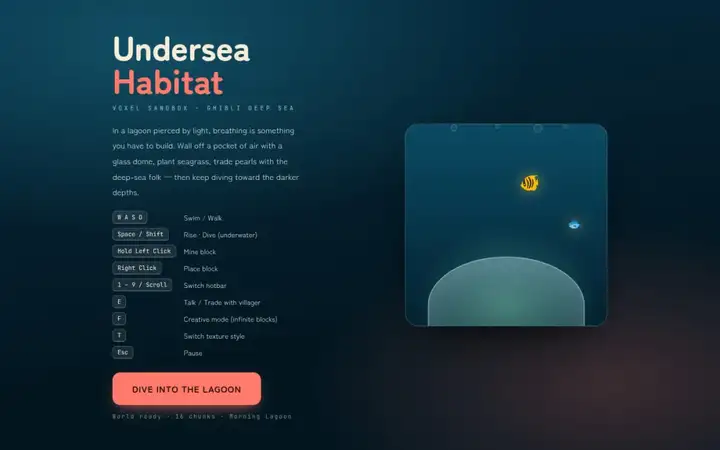
把方块世界搬到海底:海藻林、农场和深海生物围绕着可呼吸的穹顶。玩家可以挖矿、与村民交易,建造自己的水下栖息地。
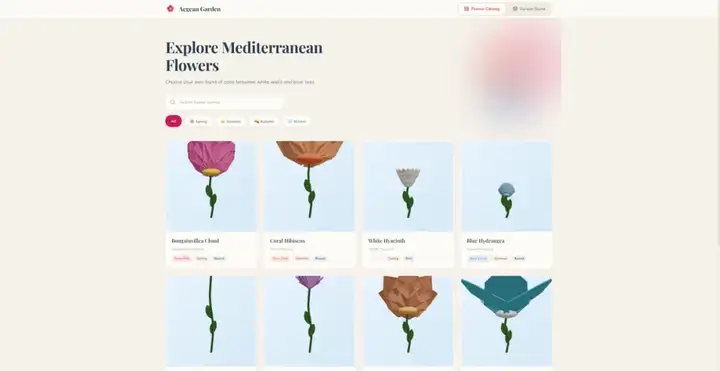
在白墙、赤陶与爱琴海蓝之间规划一座 3D 花园。九重葛的洋红点缀其中,浅浅的投影和舒展的留白,让植物与造景成为画面的中心。
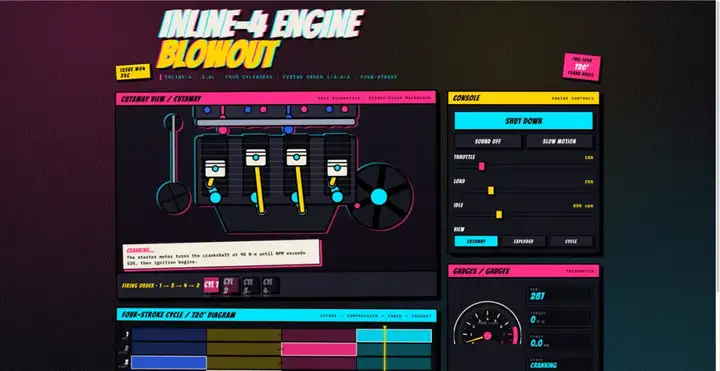
用《蜘蛛侠:平行宇宙》式的漫画风格呈现四缸发动机运转。鲜明的原色与强烈对比,让机械运动成为画面的主角。
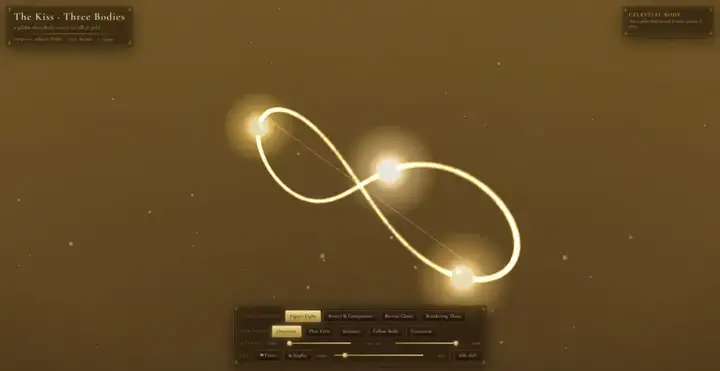
模型在 10 万步以内数值求解三体运动方程,再用 Three.js 把三条轨道渲染成发光的金丝线,整体取法克里姆特《吻》的金色装饰风格。
技术解读
模型架构:88 层混合注意力 MoE,上下文 524,288
IQuest-Q1 共 88 层 Transformer,隐藏维度 3,072;注意力为 48 个查询头与 8 个 KV 头、头维度 128,采用 3 层滑窗注意力(SWA)与 1 层全注意力(FA)交替的混合模式,滑窗大小 4,096,RoPE 只作用于 32 个维度(partial RoPE)。MoE 部分合计 256 个专家,每个 token 激活 8 个。上下文长度 524,288 token。为提升解码效率,模型还带多 token 预测(MTP):训练阶段用 2 个独立 MTP 层;推理阶段改为 1 层递归、展开 8 次,滑窗大小 512。
模型训练:合成环境中的多脚手架强化学习与 MOPD
一个智能体系统必须能够端到端地完成任务:不仅要收集信息、调用工具,还要理解反馈,并在多步执行出错时自我纠正。为了打好基础,预训练与中期训练的数据逐渐向代码和 STEM 领域倾斜,同时引入智能体轨迹、扩展上下文窗口。在此基础上,官方再通过三个阶段进一步塑造其行为模式。
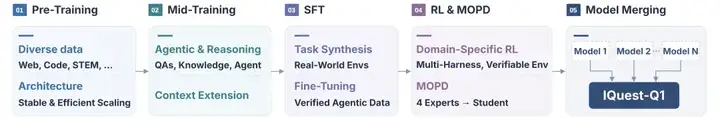
强化学习
同一策略在多种脚手架中训练,并保留各脚手架原生的工具与上下文管理,让模型在学会解题的同时,也学会在真实的智能体系统中工作。优化前先对失败归因,只有策略自身的错误才作为学习信号。
MOPD 与模型融合
通过强化学习得到四个专家模型,覆盖智能体用户体验、多脚手架协作、长程任务与通用智能体任务四个方面。通过多教师在线策略蒸馏(MOPD)把它们整合进同一个学生模型——学生模型在自己生成的轨迹上进行学习,并由匹配的专家模型对它的每一个 token 进行打分;最终通过融合贯穿各阶段的专家与分支模型,合并为 IQuest-Q1。
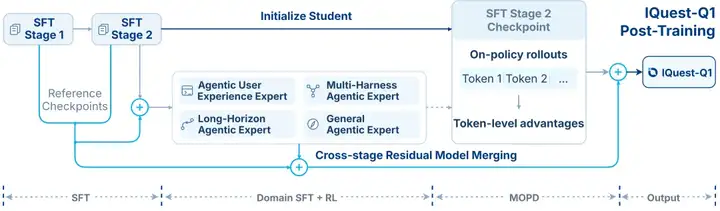
按官方给出的训练流程,强化学习先按能力方向训出四个专家,再用在线策略蒸馏收敛进同一个学生模型,最后通过跨阶段与专家分支的模型融合得到最终检查点。
模型下载与推理
模型下载
pip install -U modelscope
modelscope download --model IQuestLab/IQuest-Q1 --local_dir ./IQuest-Q1
推理部署
官方推荐用 SGLang 或 vLLM 部署,并提供了基于 CUDA 13.0 的预构建镜像。
SGLang(官方镜像 iquestlabworkspace/sglang-iquest-q1:cu130):
docker pull iquestlabworkspace/sglang-iquest-q1:cu130

# without MTP
modelscope download --model IQuestLab/IQuest-Q1 --local_dir ./IQuest-Q1 && \
MODEL_ROOT="./IQuest-Q1" && \
SGLANG_USE_MODELSCOPE=true python -u -m sglang.launch_server \
  --model-path "$MODEL_ROOT" \
  --served-model-name IQuest-Q1 \
  --tp-size 8 \
  --dtype bfloat16 \
  --attention-backend fa3 \
  --mem-fraction-static 0.85 \
  --disable-prefill-cuda-graph \
  --enable-metrics \
  --tool-call-parser iquest_q1 \
  --reasoning-parser iquest_q1 \
  --enable-torch-compile \
  --load-format fastsafetensors \
  --speculative-use-rejection-sampling

# with recursive MTP
modelscope download --model IQuestLab/IQuest-Q1 --local_dir ./IQuest-Q1 && \
MODEL_ROOT="./IQuest-Q1" && \
SGLANG_USE_MODELSCOPE=true python -u -m sglang.launch_server \
    --model-path "$MODEL_ROOT" \
    --served-model-name IQuest-Q1 \
    --tp-size 8 \
    --dtype bfloat16 \
    --attention-backend fa3 \
    --mem-fraction-static 0.85 \
    --disable-prefill-cuda-graph \
    --enable-metrics \
    --tool-call-parser iquest_q1 \
    --reasoning-parser iquest_q1 \
    --speculative-algorithm EAGLE \
    --speculative-num-steps 5 \
    --speculative-eagle-topk 1 \
    --speculative-num-draft-tokens 6 \
    --speculative-draft-model-path "$MODEL_ROOT/mtp" \
    --enable-torch-compile \
    --load-format fastsafetensors \
    --speculative-use-rejection-sampling \
    --speculative-draft-attention-backend fa3
vLLM(官方镜像 iquestlabworkspace/vllm-iquest-q1:cu130):
docker pull iquestlabworkspace/vllm-iquest-q1:cu130

# without MTP
modelscope download --model IQuestLab/IQuest-Q1 --local_dir ./IQuest-Q1 && \
MODEL_ROOT="./IQuest-Q1" && \
VLLM_USE_MODELSCOPE=true vllm serve "$MODEL_ROOT" \
  --served-model-name IQuest-Q1 \
  --tensor-parallel-size 8 \
  --reasoning-parser iquest_q1 \
  --enable-auto-tool-choice \
  --tool-call-parser iquest_q1

# with recursive MTP
modelscope download --model IQuestLab/IQuest-Q1 --local_dir ./IQuest-Q1 && \
MODEL_ROOT="./IQuest-Q1" && \
VLLM_USE_MODELSCOPE=true vllm serve "$MODEL_ROOT" \
  --served-model-name IQuest-Q1 \
  --tensor-parallel-size 8 \
  --reasoning-parser iquest_q1 \
  --enable-auto-tool-choice \
  --tool-call-parser iquest_q1 \
  --enable-prefix-caching \
  --speculative-config '{
    "method": "eagle",
    "model": "'"$MODEL_ROOT"'/mtp",
    "num_speculative_tokens": 5,
    "draft_sample_method": "probabilistic",
    "rejection_sample_method": "standard",
    "enforce_eager": false
  }
在 Claude Code 或 Codex 中使用
两者都需要通过支持工具调用的网关接入:Claude Code 使用 Anthropic Messages 接口,Codex 使用 OpenAI Responses 接口。
Claude Code(官方建议版本 2.1.140)
export ANTHROPIC_MODEL="IQuest-Q1[1m]"
export ANTHROPIC_DEFAULT_SONNET_MODEL="IQuest-Q1[1m]"
export ANTHROPIC_DEFAULT_OPUS_MODEL="IQuest-Q1[1m]"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="IQuest-Q1[1m]"
export CLAUDE_CODE_SUBAGENT_MODEL="IQuest-Q1[1m]"
export CLAUDE_CODE_MAX_OUTPUT_TOKENS="131072"
export CLAUDE_AUTOCOMPACT_PCT_OVERRIDE="80"
export CLAUDE_CODE_AUTO_COMPACT_WINDOW="524288"
export API_TIMEOUT_MS="3000000"
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC="1"
export CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS="1"
export ANTHROPIC_BASE_URL="http://example-iquest-q1-link"
export ANTHROPIC_AUTH_TOKEN="sk-iquest-q1"
claude --model IQuest-Q1
Codex CLI (推荐使用版本 0.142.0)
export OPENAI_API_KEY="sk-iquest-q1"
export MODEL_ID="IQuest-Q1"
# Add /v1 if required by your gateway's Responses endpoint.
export BASE_URL="http://example-iquest-q1-link"
(
  set -eu
  CONFIG_DIR="${HOME}/.codex"
  mkdir -p -- "$CONFIG_DIR"
  CONFIG_DIR="$(cd -- "$CONFIG_DIR" && pwd -P)"
  # Back up existing files before replacing them.
  BACKUP_SUFFIX="$(date +%Y%m%d-%H%M%S)-$$"
  for FILE in config.toml model_catalog.json; do
    if [ -f "$CONFIG_DIR/$FILE" ]; then
      cp -p -- "$CONFIG_DIR/$FILE" "$CONFIG_DIR/$FILE.bak.$BACKUP_SUFFIX"
    fi
  done
  # This configuration disables approval prompts and sandboxing.
  cat > "$CONFIG_DIR/config.toml" <<EOF
model = "$MODEL_ID"
model_provider = "iquest"
approval_policy = "never"
sandbox_mode = "danger-full-access"
web_search = "disabled"
model_reasoning_summary = "detailed"
model_supports_reasoning_summaries = true
model_context_window = 524288
model_auto_compact_token_limit = 419430
model_auto_compact_token_limit_scope = "total"
tool_output_token_limit = 32768
model_catalog_json = "$CONFIG_DIR/model_catalog.json"
[model_providers.iquest]
name = "iquest"
base_url = "${BASE_URL%/}"
wire_api = "responses"
env_key = "OPENAI_API_KEY"
supports_websockets = false
request_max_retries = 20
stream_max_retries = 20
stream_idle_timeout_ms = 600000
[model_providers.iquest.http_headers]
max-output-tokens = "131072"
EOF
  # The gateway must support the reasoning options and max-output-tokens header.
  cat > "$CONFIG_DIR/model_catalog.json" <<EOF
{
  "models": [
    {
      "slug": "$MODEL_ID",
      "display_name": "$MODEL_ID",
      "description": "IQuest-Q1 served through an API gateway.",
      "context_window": 524288,
      "input_modalities": ["text"],
      "base_instructions": "",
      "supported_reasoning_levels": [],
      "supports_reasoning_summaries": true,
      "supports_parallel_tool_calls": false,
      "shell_type": "default",
      "tool_mode": "default",
      "truncation_policy": {
        "mode": "tokens",
        "limit": 10000
      },
      "visibility": "list",
      "supported_in_api": true,
      "priority": 1,
      "support_verbosity": false,
      "experimental_supported_tools": []
    }
  ]
}
EOF
  codex --model "$MODEL_ID"
)
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 1
 0
- 0


 已为社区贡献1103条内容

所有评论(0)