斯坦福&英伟达开源 CLM-8B:75MB 对比学习验证器,DeepSWE 81.6% 刷新 SOTA
9 月 23 日,斯坦福大学与 NVIDIA Research 联合团队发布 Contrastive Language Models(CLM),一类用对比学习目标训练的System One决策模型。首发版本 CLM-8B 用一个状态编码器加一个动作编码器,把当前状态与候选动作映射进同一嵌入空间,按余弦相似度打分,直接充当零样本动作分类器和验证器:骨干是冻结的 Qwen3-8B,只训练 2000 万参数的 MLP 投影头,检查点仅 75MB。
零样本场景下与对照基线 Jev 性能相当而延迟低至 1/9;轻量微调后作为轨迹验证器,在 DeepSWE(81.6%)与 Terminal-Bench 2.1(87.6%)上刷新两项基准的验证器 SOTA,验证推理快 4–6 倍。
● 模型下载:https://modelscope.cn/models/Contrastive-LM/CLM-v0.1-8B
● 预训练数据集:https://modelscope.cn/datasets/Contrastive-LM/CLM-v0.1-Pretrain-Nemotron
● GitHub:https://github.com/Contrastive-LM/CLM
● 技术博客:https://contrastive-lm.notion.site
01
效果案例
案例一:Dino Run 赛跑
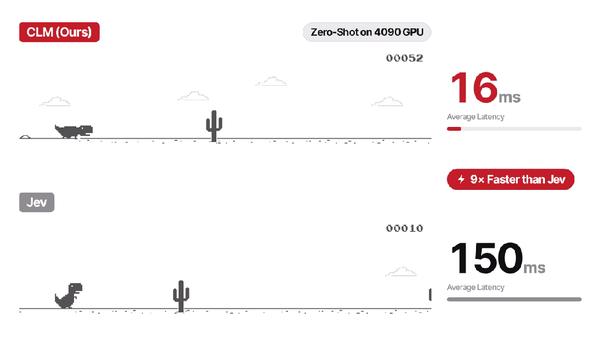
零样本直接玩 Chrome 小恐龙(T-Rex)跑酷游戏:每一步把屏幕状态和四个候选动作交给 CLM 打分,选最高分执行。单张 RTX 4090 上平均延迟约 16 ms,对照 Jev 为 150 ms,快 9 倍。
案例二:客服工单分诊
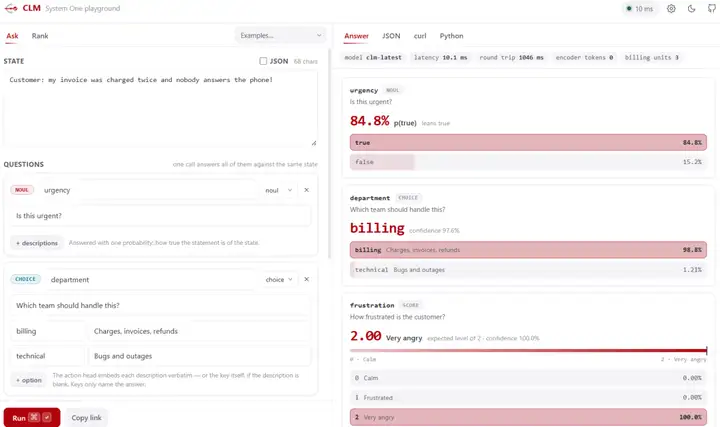
官方 Playground 里对一条真实语气的工单「我的发票被扣了两次,打电话还没人接!」同时问三个带类型的问题:是否紧急(Noul)、该哪个团队处理(Choice)、客户愤怒程度(Score)。CLM 一次调用全部作答:紧急度 84.8%、路由到 billing(98.8%)、愤怒等级Very angry(100%);单次打分延迟约 10 ms,冷缓存时整轮往返约 1 秒(各选项文本首次需嵌入,之后走缓存)。
02
技术解读
架构:冻结 Qwen3-8B + 2000 万参数投影头
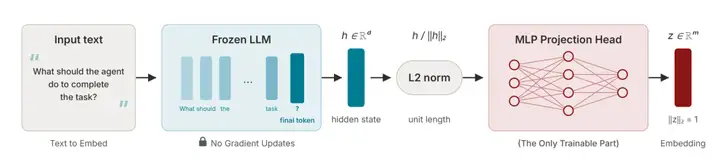
CLM 由状态编码器和动作编码器组成,两个编码器把各自输入映射进共享嵌入空间,状态-动作对的得分就是两者嵌入的余弦相似度。每个编码器的结构相同:冻结的 LLM 骨干(Qwen3-8B)取最后一个 token 的隐藏态,做 L2 归一化,再过一个 MLP 投影头,输出单位长度的嵌入。全程只有 2000 万参数的投影头参与训练,LLM 骨干冻结、不接收梯度。这套设计让训练实验极其便宜:LLM 嵌入可以预先算好、在不同头配置间反复复用,在 Nemotron DQA 上跑完整预训练,单张 RTX 4090 约一小时。
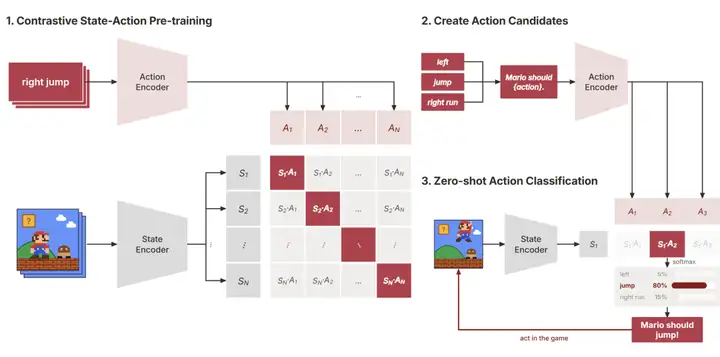
训练好后,两个编码器直接就是零样本动作分类器:新状态过状态编码器,与各候选动作的嵌入逐一算相似度,softmax 就是答案分布。下图以 Super Mario 为例给出完整三阶段,对比预训练、构造候选动作、零样本分类:
训练目标:双向 InfoNCE,中期训练加硬负例
预训练用双向 InfoNCE:给定一批 B 个配对的状态-动作对,计算 B×B 相似度矩阵,对每个正样本对 (s_i, a_i) 同时优化两个方向的检索:s→a 与 a→s;正对相似度经温度 τ 缩放后做 softmax,同批其余样本充当负例。用官方的话说:每个状态被拉向真实发生的动作、推离其余所有动作。中期训练在此之上引入硬负例——状态→动作方向的分母中,除批内负样本外再计入 K 个硬负例的相似度项。
三阶段数据配方
CLM 分三阶段训练,每阶段做一种更难的状态-动作对齐:预训练学宽泛语义表示,中期训练练细粒度辨别力,后训练把表示空间适配到动作分类。
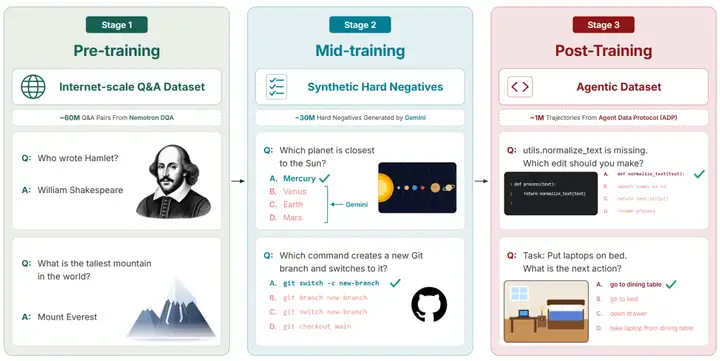
- 阶段一(预训练):约 6000 万对 Nemotron DQA 问答对,问题当状态、答案当动作,从大规模语料学宽泛语义。
- 阶段二(中期训练):约 3000 万条 Gemini 2.5 Flash-Lite 生成的合成硬负例——对部分 DQA 问题构造语义相近但错误的答案,预先算好、按硬负例损失并入。
- 阶段三(后训练):约 100 万条智能体轨迹(Agent Data Protocol 数据集,辅以 Endless-Terminals、LiteCoder-Terminal-SFT 的终端轨迹),每一步表示为状态-动作对,状态含智能体当前上下文、动作是对应决策。
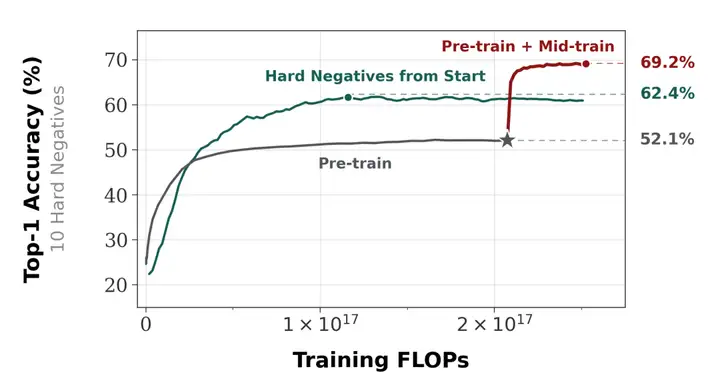
两个消融实验支撑了这套配方。其一,硬负例不该从第一天就上:在约 10 万个留出问题(1 个金标准答案 + 10 个硬负例)上,纯预训练 top-1 准确率 52.1%,接一段中期训练提到 69.2%;而从头就在硬负例上训练虽然起步快,但峰值只有 62.4% 后过拟合,同等算力预算下两阶段方案高出约 7 个百分点。
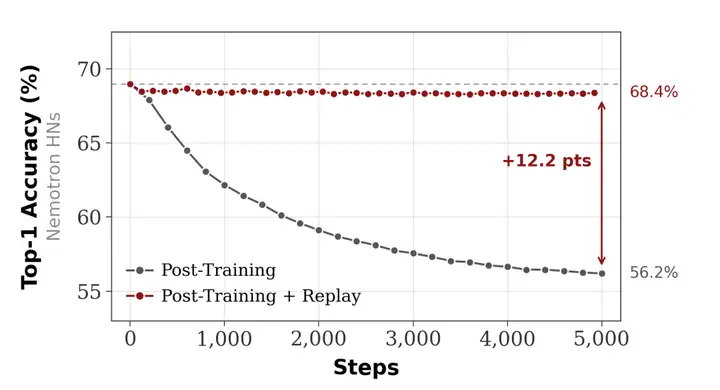
其二,后训练要用数据回放防遗忘:后训练混合 40% Nemotron DQA 回放 + 60% 智能体轨迹。有回放时,Nemotron 硬负例 top-1 准确率仅从 69% 微降到 68.5%;同样步数只训智能体数据,则跌到 56.2%。
预训练重塑表示空间
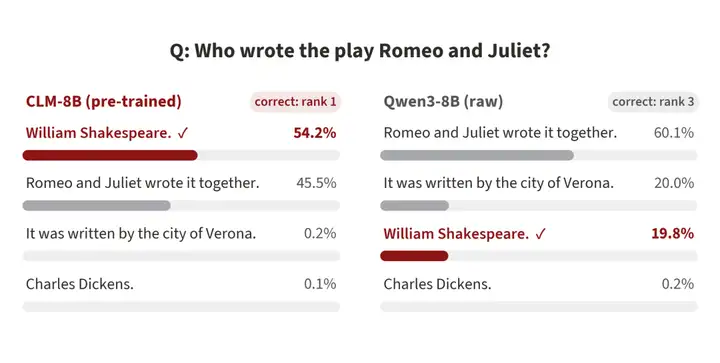
预训练后立刻评测 CLM-8B:问 Who wrote the play Romeo and Juliet? 原始 Qwen3-8B 嵌入把最高概率给了错误答案,William Shakespeare 只排第三(19.8%);CLM-8B 则把它排在第一,54.2%。官方据此说明:对比预训练把模型表示整成了可用的决策空间。
验证任务的 Scaling Laws
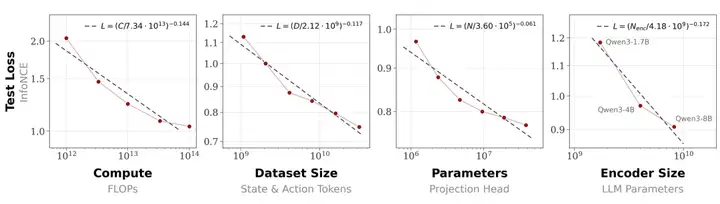
团队在 Nemotron DQA 上做了一组缩放实验:测试 InfoNCE 损失随训练算力 C、数据量 D、投影头规模 N、编码器规模 N_enc 的变化都符合幂律 L(X) ≈ (X_c/X)^α(拟合方法沿用 Kaplan et al.),四个维度需要联合缩放才能达到最优验证性能;官方称其中扩大编码器(LLM 骨干)规模的收益最大。
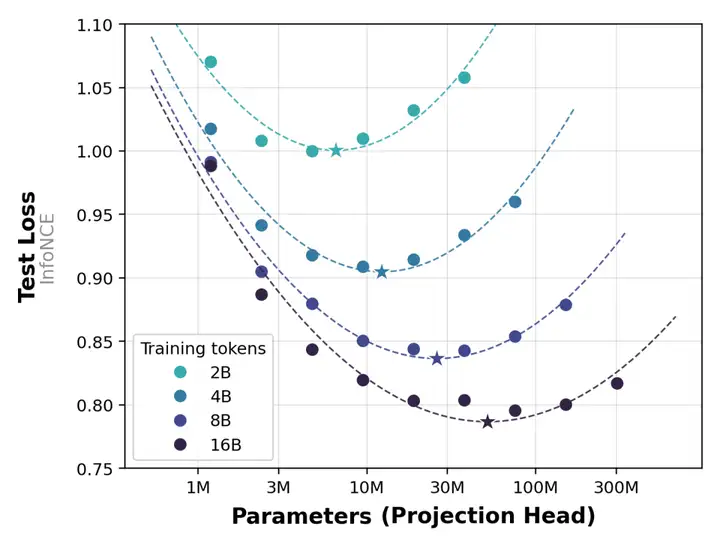
固定算力预算下,把测试损失对投影头参数量画曲线,在 log 参数空间里近似抛物线,最低点即该数据预算下的最优头规模;预算越大,最优点越靠右,最优头规模与训练 token 数几乎精确线性(N* ∝ D^1.02,约每参数 310 个 token)。
CLM-8B 是团队 scaling ladder 上的一环,按这些规律训练多个规模、外推更大规模的表现。官方预告多模态 CLM-35B 已在训练中,预计下月初发布;此前他们还发布过机器人变体 CoVer-VLA,做 VLA 模型的验证缩放。
状态与动作解耦:动作缓存
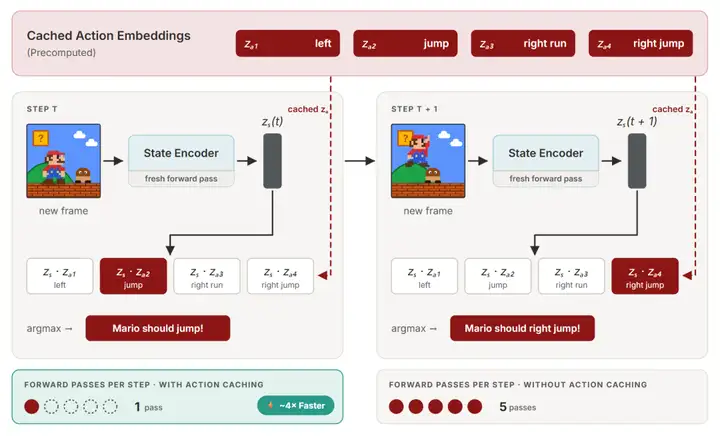
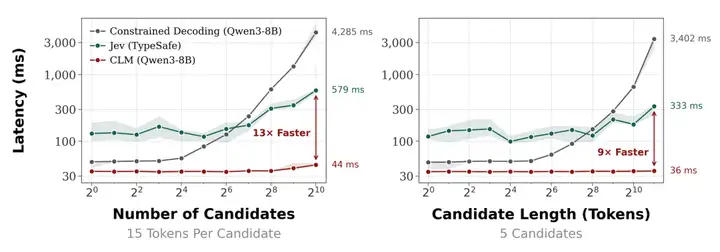
因为状态和动作是解耦的两路编码,两侧嵌入可以各自缓存、独立复用。状态持续变化而动作集合固定的场景收益最大:4 个动作嵌入在开局前预先算好,每步只需新画面过一次状态编码器,与缓存动作嵌入打分,每步前向从 5 次降到 1 次。候选数与上下文越长收益越大:约 1000 个候选时,CLM 比 Jev 快 13 倍。
03
性能表现
零样本评测:与 Jev 相当,延迟最高快 9 倍
官方在计算机使用、游戏、工具调用等任务上做零样本对比:
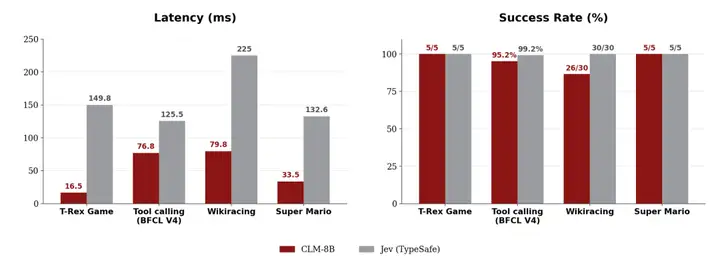
成功率互有胜负,BFCL v4 与 WikiRacing 两项略低于 Jev,但延迟全面低于 Jev。加速在候选动作多(WikiRacing)或动作跨状态复用(T-Rex)时最显著,官方口径为最高 9 倍。
智能体基准:作为验证器的官方成绩
评测设定:每道题先用前沿模型采样多个候选解(DeepSWE 用 Opus 5、Terminal-Bench 2.1 用 Fable 5),CLM 或 Jev 作为验证器从候选中挑最优;在 38 个留出 DeepSWE 任务与 30 个留出 Terminal-Bench 2.1 任务上评测,延迟在 H100 上测得。
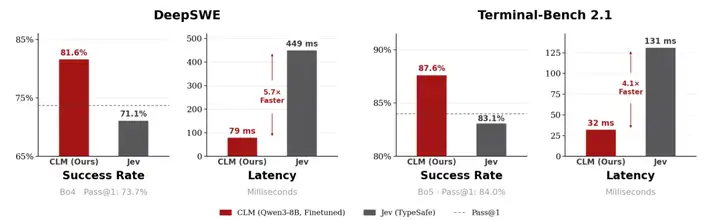
官方发现 Jev 在这类长程任务上无法胜任验证器,成绩低于随机挑一个的 Pass@1 基线;CLM 轻量微调后官方报告在两个基准上均刷新验证器 SOTA(DeepSWE 81.6% 即 31/38),验证推理比 Jev 快 4.1–5.7 倍。
候选规模扩大时的延迟
候选越多、上下文越长,动作缓存的优势越大。每候选 15 token、约 1000 个候选时:CLM 44 ms、Jev 579 ms(快 13 倍)、约束解码 4285 ms;固定 5 个候选、拉长到约 1000 token 时:CLM 36 ms、Jev 333 ms(快 9 倍)、约束解码 3402 ms。
模型下载
pip install -U modelscope
modelscope download –model Contrastive-LM/CLM-v0.1-8B
  –local_dir ./CLM-v0.1-8B
推理服务
pip install contrastive-lm

# 1. 编码器(Qwen3-8B 嵌入服务)
vllm serve Qwen/Qwen3-8B --served-model-name qwen3-8b --runner pooling --max-model-len 2048 --port 8090 &

# 2. CLM API(8700 端口,首次运行自动下载 75MB 参考头)
clm-serve
调用:一次回答一串带类型的问题
from clm import CLMClient, Choice, Noul, Score

client = CLMClient()                          # CLM_BASE_URL(默认 http://127.0.0.1:8700)
r = client.system_one(
    state="Customer: my invoice was charged twice and nobody answers the phone!",
    questions={
        "urgency": Noul(instructions="Is this urgent?"),
        "department": Choice(instructions="Which team should handle this?",
                             criteria={"billing": "Charges, invoices, refunds",
                                       "technical": "Bugs and outages"}),
        "frustration": Score(instructions="How frustrated is the customer?",
                             criteria=["Calm", "Frustrated", "Very angry"]),
    },
)
print(r.answers["urgency"].noul)                # 0.41022     命题为真的概率
print(r.answers["department"].choice)           # billing
print(r.answers["frustration"].score)           # 1.98386     期望等级 0..2
自由候选(best-of-N 答案、工具名、下一步动作)用进程内引擎直接排序,不需要起服务:
from clm import Engine

engine = Engine(emb_url="http://127.0.0.1:8090/v1/embeddings")
engine.rank("What causes tides on Earth?",
            ["The Moon's gravitational pull.", "Photosynthesis in plants.",
             "Because the Earth is round."])
# [{'rank': 1, 'candidate': "The Moon's gravitational pull.", 'prob': 0.997}, ...]
模型微调
在自己的数据上微调只需训练投影头,官方给出 DeepSWE 复现与微调入口:
# 复现 DeepSWE 留出 38 任务结果(31/38 = 81.6%)
modelscope download --model Contrastive-LM/deepswe-clm-heads-8k --local_dir heads/deepswe
python evaluation/bon_eval.py --hf-dataset Contrastive-LM/deepswe-clm-embeddings-8k \
    --checkpoint heads/deepswe/best_head.pt \
    --tasks-file heads/deepswe/heldout_tasks.json --n 4 --window 12

# 微调对应的 DeepSWE 头
python train/finetune.py --task clm --init-ckpt "$(clm-download)" \
    --out-dir runs/deepswe --holdout-tasks heads/deepswe/heldout_tasks.json --batch 512
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1103条内容

所有评论(0)