紫东太初开源 ZDTaichu5.0-9B:9B 通用多模态8 项空间基准登顶,对标前沿闭源模型 GPT‑6 Astra
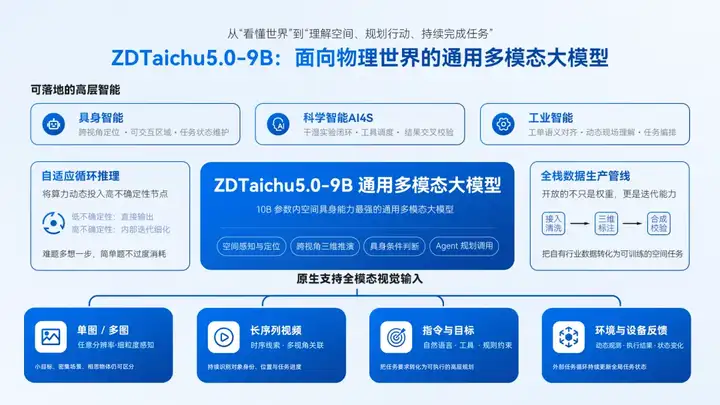
紫东太初开源新一代面向物理世界的通用多模态大模型 ZDTaichu5.0-9B。它以 Qwen3.5-9B 为语言骨干、C-RADIOv4-H 为视觉骨干,参数量约 9B,支持文本、单图、多图与视频,最高 128K token 上下文和任意分辨率视觉输入。
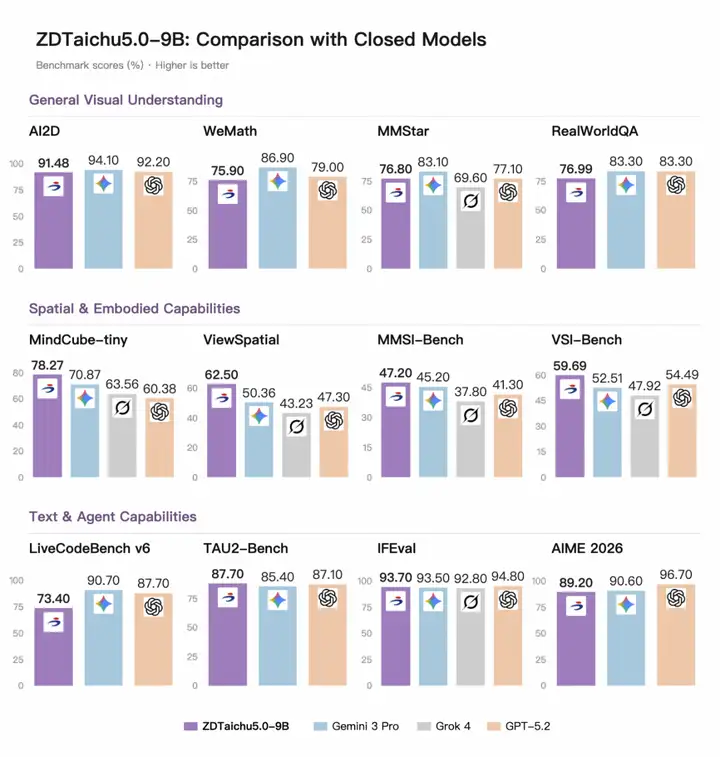
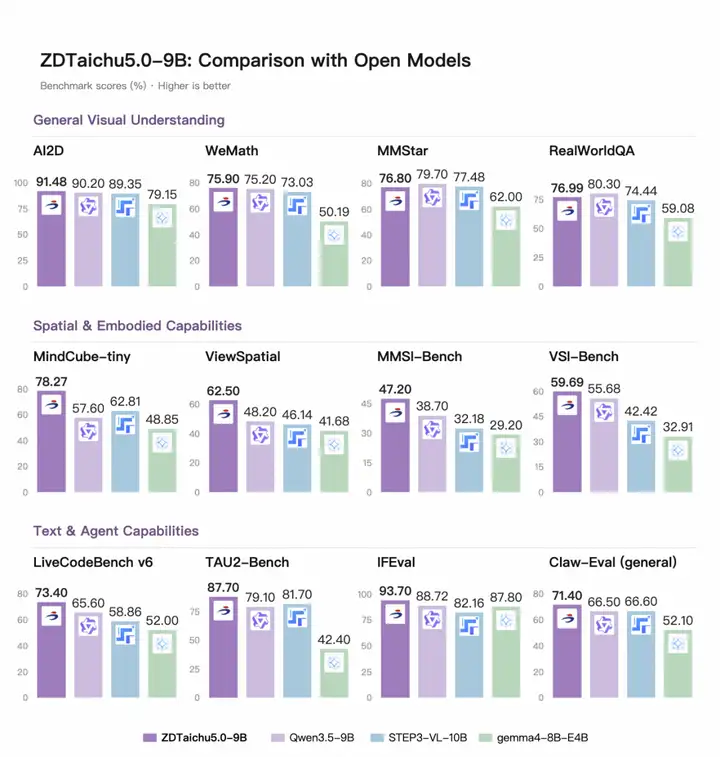
依据九大国际权威空间理解基准横向评测结果: ZDTaichu5.0‑9B 为 10B 参数内空间具身能力最强的通用多模态大模型,9 项基准斩获 8 项组别第一。创新采用自适应循环推理架构,对标行业前沿闭源模型 GPT‑6 Astra,ZDTaichu5.0‑9B 展现出高度对齐的技术前瞻性。
模型下载:
https://www.modelscope.cn/models/TaichuAI/ZDTaichu5.0-9B
代码仓库:
https://github.com/Taichu-AI/ZDTaichu5.0-9B
项目主页:
https://taichu-ai.github.io/ZDTaichu5.0-9B/zh.html
效果与能力
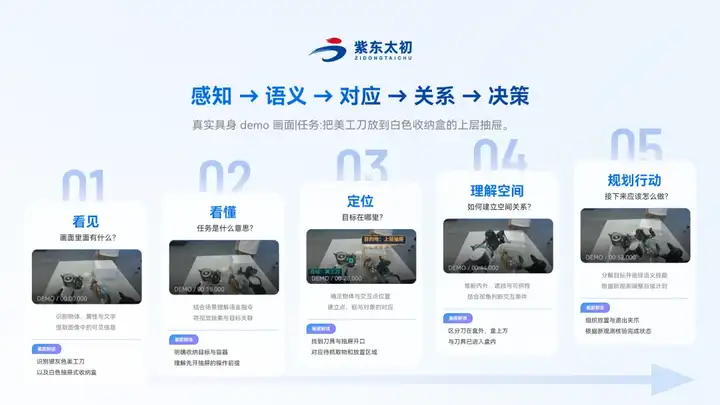
ZDTaichu5.0-9B 的能力链条:空间感知 → 复杂三维空间推理 → 具身条件推理 → 物理交互决策,对应「从看懂二维世界,到理解三维物理世界并规划决策」。
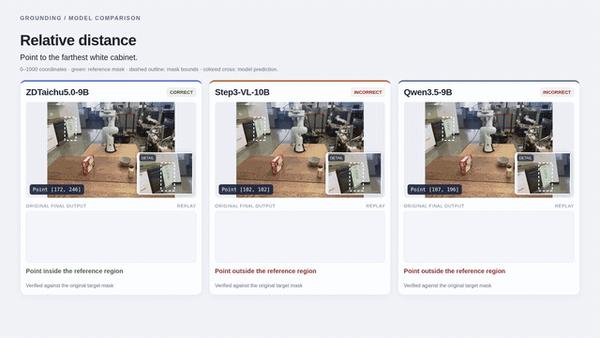
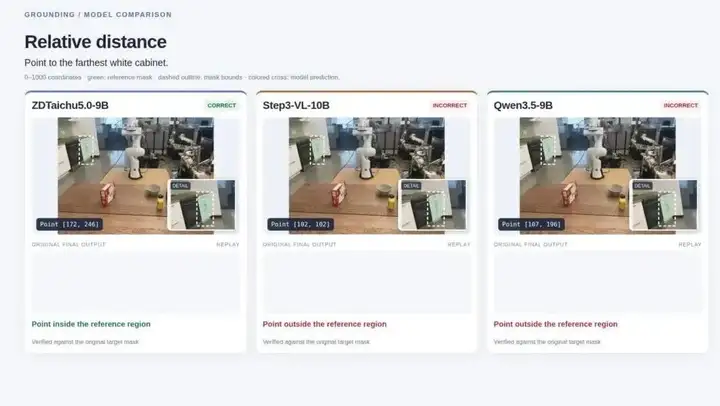
空间能力:目标定位、杯柄方向推理与多视角心理旋转
从目标定位、计数与相对位置判断,延伸到跨视角关联、深度与布局理解、参照系转换、心理旋转、截面推理及高层操作规划。
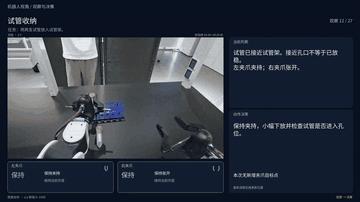
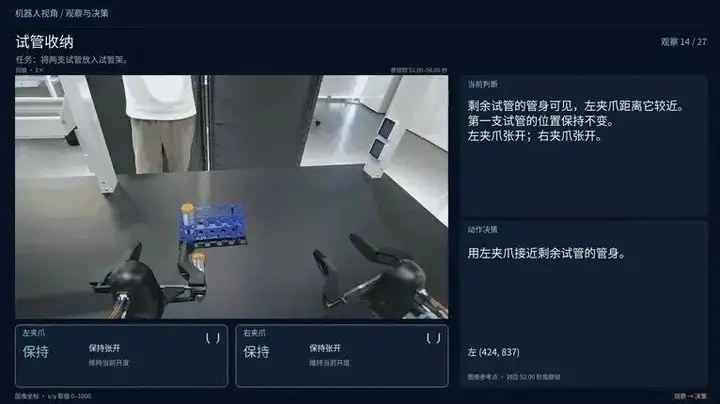
具身理解与行动规划
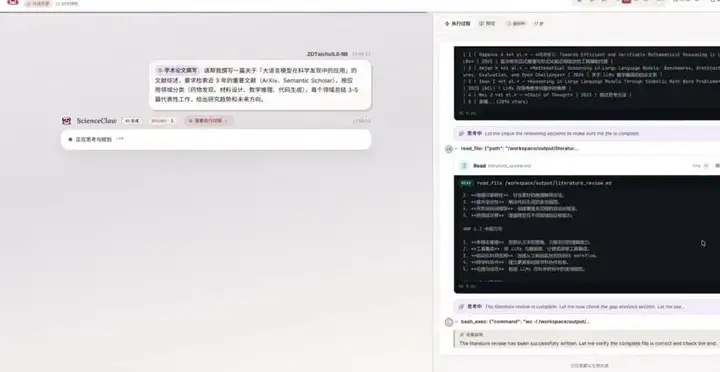
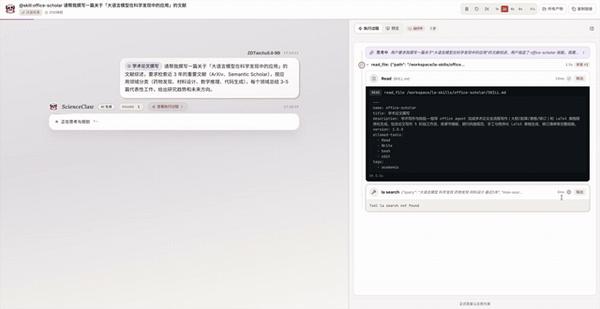
Agent 工具使用
结合检索与文档生成的文献综述
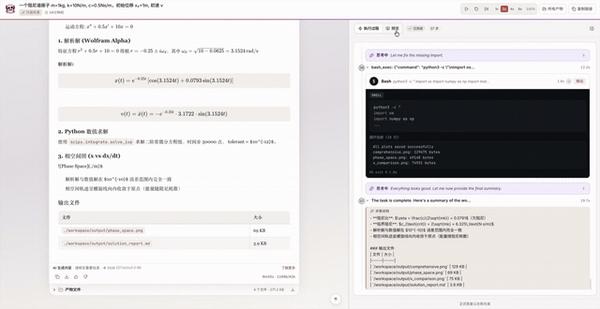
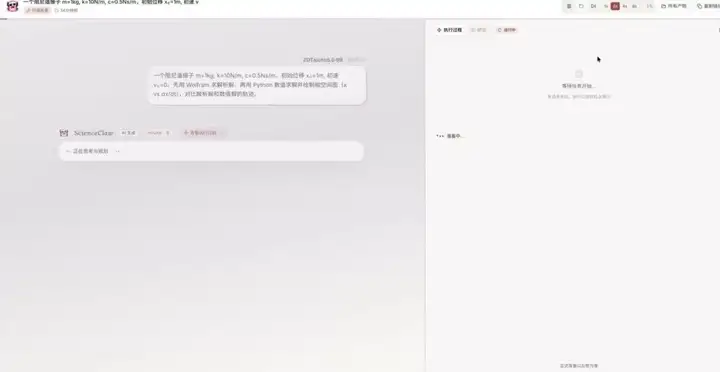
结合工具与可视化校验的科学计算
多阶段训练:从感知对齐到具身推理
ZDTaichu5.0-9B 是面向通用视觉理解、空间推理、Agent 工具使用及具身智能研究的多模态基础模型。它结合 Qwen3.5-9B 语言骨干与 C-RADIOv4-H 视觉编码器,支持文本、图像和视频,并支持任意分辨率视觉输入。
多模态预训练
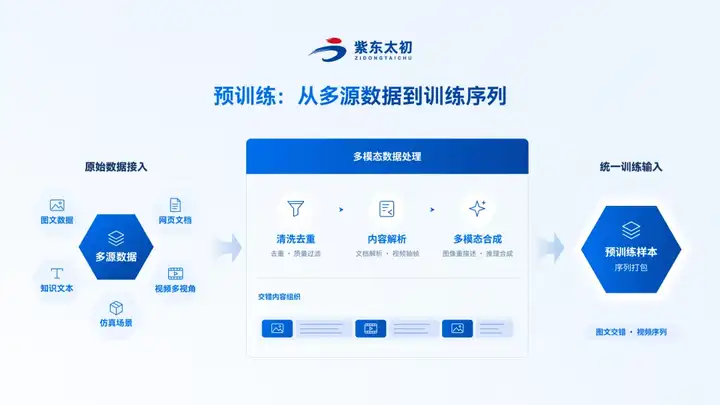
预训练数据覆盖开源图文、结构化网页文档、公开视频多视角素材,以及仿真渲染的三维空间场景。原始数据经过感知哈希与 URL 双重去重,并依次完成清晰度、图文相关性、隐私和内容安全过滤。针对不同模态,训练流程还加入文档重写与结构解析、视频抽帧和画面描述,建立视觉、语言、时序与三维空间概念之间的基础对齐。
基于任务轨迹的监督微调
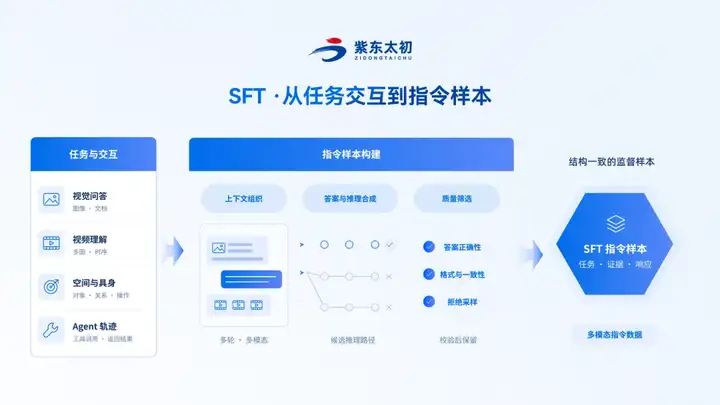
SFT 阶段使用的不只是普通问答数据,还包括开源指令、真实业务问答、空间具身案例和 Agent 完整工具调用轨迹。数据会经过指令质量评分、答案正确性校验和难度分层;具身样本还需检查图像、问题、目标对象与操作约束是否一致。
训练样本通过多轮对话、多图拼接和视频序列打包构建。带步骤的推理数据生成后,还会经过拒绝采样、格式校验与一致性检查,过滤错误和低质量内容,使模型能够结合视觉证据完成任务拆解、工具调用和多轮具身交互。
高质量退火与 GRPO 强化学习
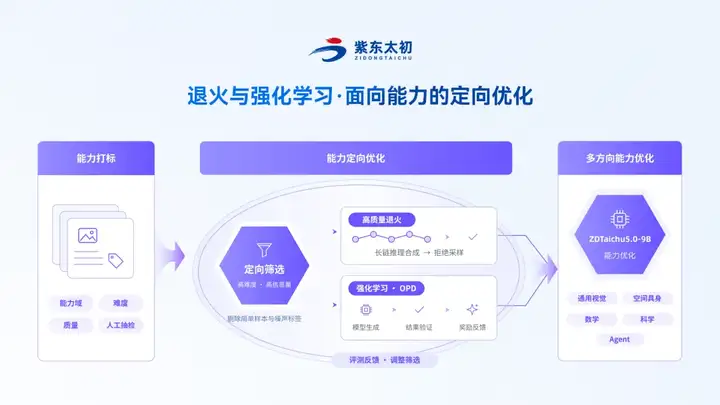
训练体系建立了“能力域—难度—质量”三维自动标签系统,并与评测基准中的能力维度对应。模型在评测和实践中暴露出的能力短板,可以进一步用于定向筛选高难度、高信息密度样本,同时减少低质量数据对训练效果的干扰。
高质量退火阶段重点使用长推理样本。强化学习阶段采用 GRPO 框架,引入答案正确性、空间框选坐标命中和输出格式合规等可自动验证的奖励信号,将空间点位预测、结构化规划等任务转化为可反馈、可优化的训练目标。该流程支持整合超长视频、多模态证据和长链条具身推理信息。
原生自适应循环推理
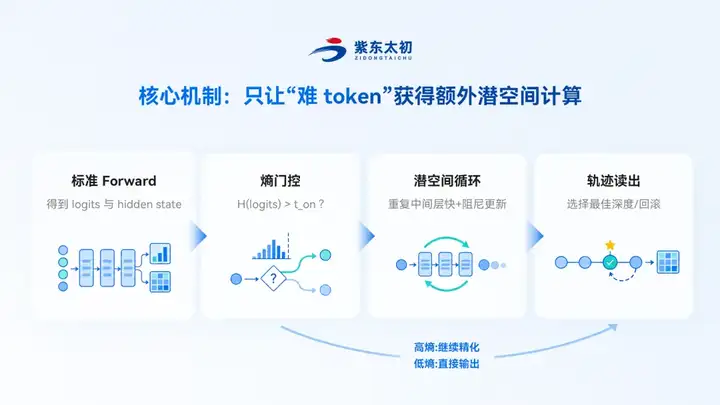
DTaichu5.0-9B 在模型内部引入自适应循环推理机制。与依赖外显思维链或外部工具反复驱动的方案不同,该机制运行于模型前向传播过程,使模型能够在潜空间中迭代更新中间表示,并根据任务复杂度动态完成多轮计算。
这一路线与 Loop Transformer 的核心思路相近:将部分复杂推理过程收敛到模型内部,而不是依赖持续生成显式思维链 Token。相比直接关联尚未公开证实的模型架构,这种表述更符合公众号对技术准确性的要求。
面向长程任务的具身智能
在上述训练机制基础上,DTaichu5.0-9B 面向长程具身任务强化了持续感知、任务规划和自主决策能力,使模型能够结合连续视觉信息理解环境变化,并在多轮交互中推进任务执行,为物理世界中的持续交互提供基础能力。
模型下载与本地推理
模型下载
pip install -U modelscope

modelscope download \
  --model TaichuAI/ZDTaichu5.0-9B \
  --local_dir ./ZDTaichu5.0-9B
通过transformers 推理
环境安装:
pip install tranformer==5.3.0 torch==2.10.0 torchvision==0.25.0 accelerate timm
推理脚本:
import os
import torch
from transformers import AutoModel, AutoProcessor

model_id = os.environ["ZDTAICHU_MODEL_ID"]  # 例如本地下载目录或 TaichuAI/ZDTaichu5.0-9B
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True, use_fast=False)
model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="sdpa",
).eval()

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "floorplan.png"},
            {"type": "text", "text": "Which room is directly to the left of the kitchen?"},
        ],
    }
]
inputs = processor.from_messages(messages, return_tensors="pt").to(model.device)
with torch.inference_mode():
    output_ids = model.generate(**inputs, max_new_tokens=1024, do_sample=False)
generated_ids = output_ids[:, inputs["input_ids"].shape[1]:]
print(processor.batch_decode(generated_ids, skip_special_tokens=True)[0])
vLLM部署
官方适配了 vLLM v0.26.0 分支,加入该架构所需的架构、量化和推测解码功能,支持Docker 和源码部署,Docker 方式要求 CUDA ≥ 12.9、NVIDIA 驱动 ≥ 575.51.03。
docker部署:
docker run -d \
  -e CUDA_VISIBLE_DEVICES=0 --gpus all \
  --privileged --ipc=host \
  -p 18050:8000 \
  registry-dx.wair.ac.cn/taichu-public/vllm-openai:v0.26.0.zdtaichu_5_0 \
  TaichuAI/ZDTaichu5.0-9B \
    --max-model-len 220000 \
    --served-model-name zdtaichu \
    --mamba-ssm-cache-dtype float32 \
    --gdn-prefill-backend triton \
    --trust-remote-code \
    --tensor-parallel-size 1 \
    --generation-config vllm
从源码安装:https://github.com/Taichu-AI/vllm · 分支 v0.26.0-zdtaichu
git clone -b v0.26.0-zdtaichu https://github.com/Taichu-AI/vllm.git
cd vllm
pip install -e .

vllm serve TaichuAI/ZDTaichu5.0-9B \
  --max-model-len 220000 \
  --served-model-name zdtaichu \
  --mamba-ssm-cache-dtype float32 \
  --gdn-prefill-backend triton \
  --trust-remote-code \
  --tensor-parallel-size 1 \
  --generation-config vllm
服务器在 http://:18050/v1 提供 OpenAI 兼容的端点。推理脚本如下:
import base64
import requests
URL = "http://<host>:18050/v1/chat/completions"
def data_url(path: str, mime: str) -> str:
    """Encode a local file as a base64 data URI."""
    with open(path, "rb") as f:
        return f"data:{mime};base64," + base64.b64encode(f.read()).decode()
def chat(body: dict) -> str:
    resp = requests.post(URL, json=body, timeout=600)
    resp.raise_for_status()
    return resp.json()["choices"][0]["message"]["content"]
#Text
-only input
body = {
    "model": "zdtaichu",
    "messages": [{"role": "user", "content": "Hello"}],
    "temperature": 1.0,
    "top_p": 0.95,
    "top_k": 20,
}
print(chat(body))
#Image
 input (local file, base64)
body = {
    "model": "zdtaichu",
    "messages": [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Which room is directly to the left of the kitchen?"},
                {"type": "image_url", "image_url": {"url": data_url("floorplan.png", "image/png")}},
            ],
        }
    ],
    "temperature": 0,
    "top_p": 0.95,
    "top_k": 20,
}
print(chat(body))
# Video input (local file, base64)
body = {
    "model": "zdtaichu",
    "messages": [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Please describe the video."},
                {"type": "video_url", "video_url": {"url": data_url("example.mp4", "video/mp4")}},
            ],
        }
    ],
    "media_io_kwargs": {
        "video": {
            "num_frames": 8,
        },
    },
}
print(chat(body))
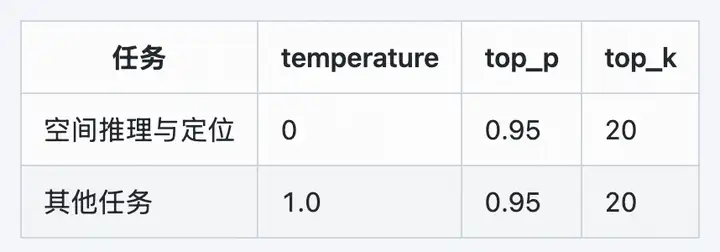
官方推荐的采样参数:
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1089条内容

所有评论(0)