Atria Dawn Preview 开源:7440 亿参数,多项基准比肩顶尖闭源模型
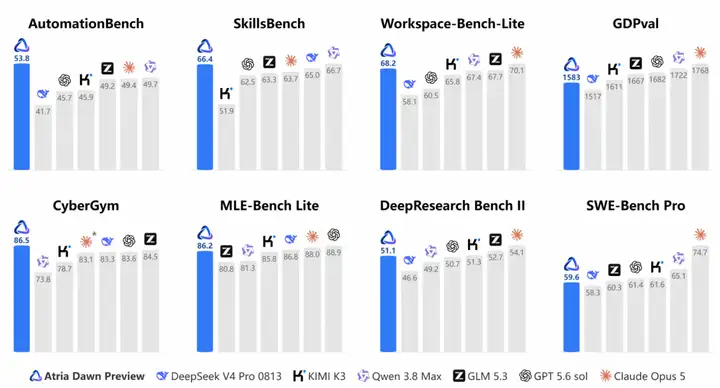
上海人工智能实验室 Atria 团队发布 Atria Dawn Preview,一款面向科学研究、工程开发与专业工作流的智能体基础模型。该模型基于 7440 亿参数 MoE GLM-5.2 基座模型构建,支持 256K 上下文,重点解决开放任务中的持续环境理解、工具调用、多步骤执行与失败恢复。其可验证经验流水线将任务目标、智能体轨迹、中间产物和外部证据连接起来,让任务完成从“生成答案”推进到“产出可执行、可验证、可复现的结果”。在覆盖真实研究、工程和数字工作的 16 项基准测试中,Atria Dawn Preview 在 5 项取得已报告的最高分,另有 3 项位列第二。
开源地址:
模型链接
https://www.modelscope.cn/models/Shanghai_AI_Laboratory/Atria-Dawn-Preview
技术报告
https://github.com/atria-asi/Atria-Dawn-Preview/blob/main/atria-dawn-preview.pdf
案例研究case
Atria Dawn Preview 的案例覆盖 Discovery、Creation、Delivery 和 Cybersecurity 四类场景,重点考察模型能否理解环境、调用工具、根据反馈调整行动,并将开放任务推进到可验证的结果。
科研与深度研究
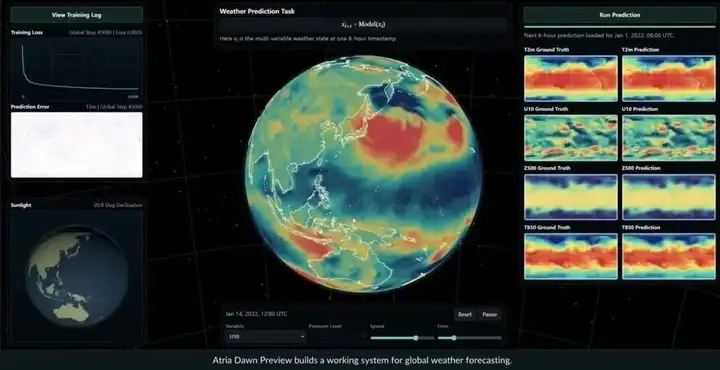
天气预报|处理超过 100 GB 全球气象数据
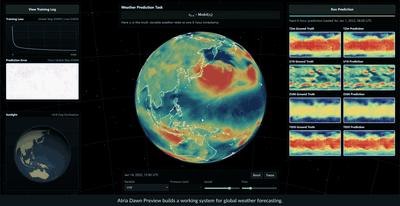
在禁用网络搜索的环境中,Atria Dawn Preview 构建了参数量超过 4 亿的 ViT 气象模型,并训练 45,000 步,建模 69 个气象变量。生成的系统可在 1 分钟内预测未来一周全球天气,部分指标优于使用更多训练数据的 FourCastNet。
全球天气预报系统演示:
自主科研|从研究想法到可运行实验
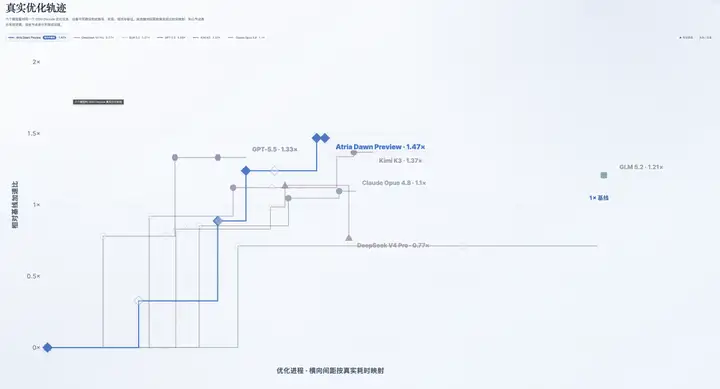
模型围绕 GDN 解码性能持续修改实现、运行测试并分析回归,识别启动开销后将 Triton 实现切换为原生 CUDA。开发阶段汇总延迟比达到 1.46×,54 个正式负载中有 52 个通过。
Atria全流程自主优化GDN kernel:
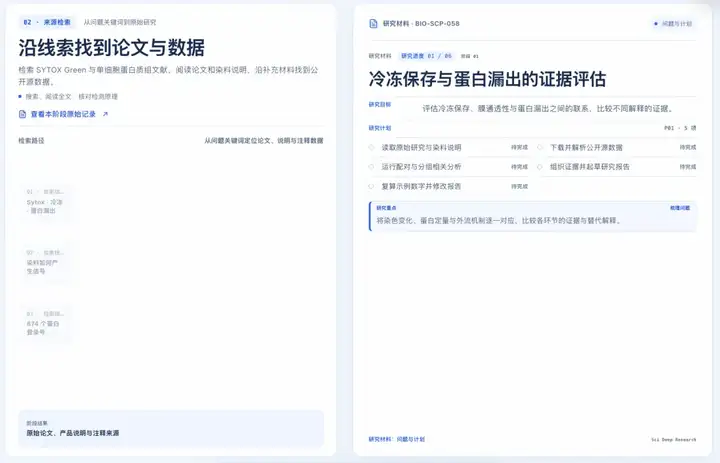
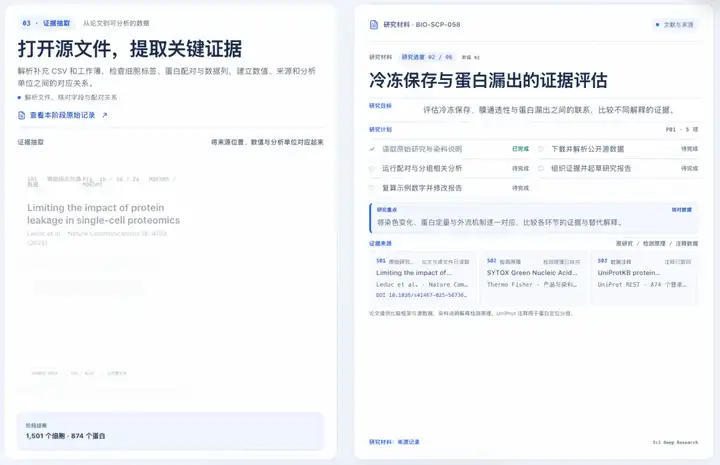
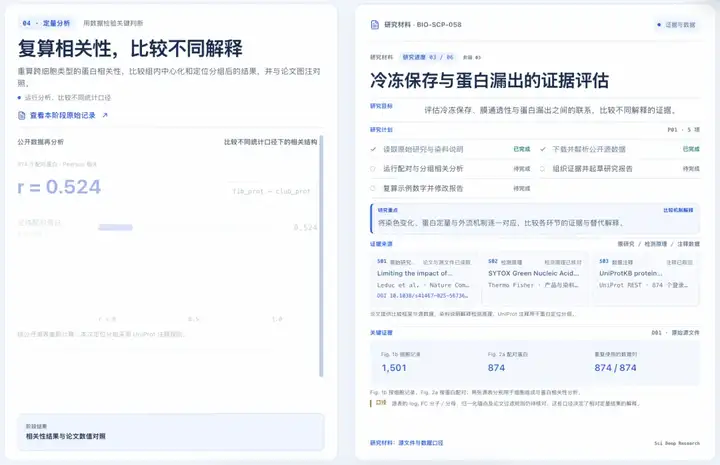
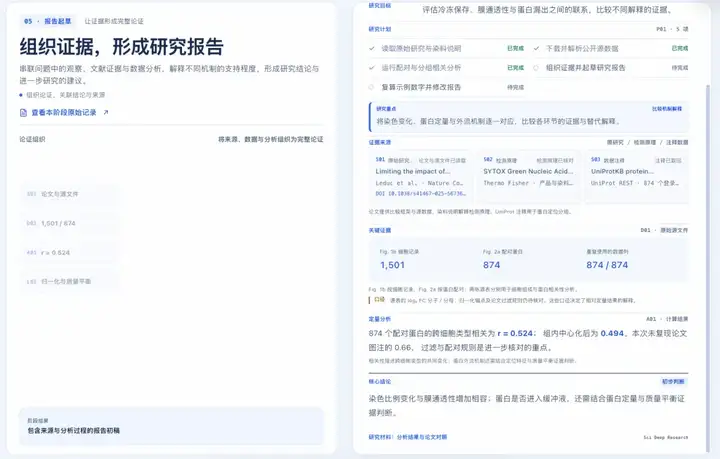
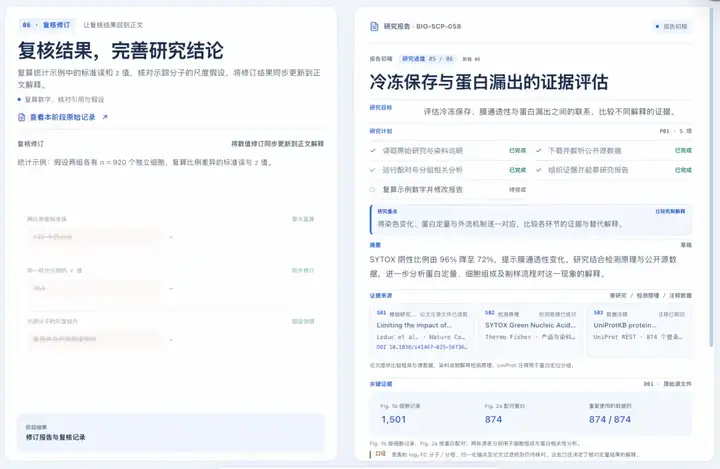
科研深度研究|在复杂问题中建立完整证据链
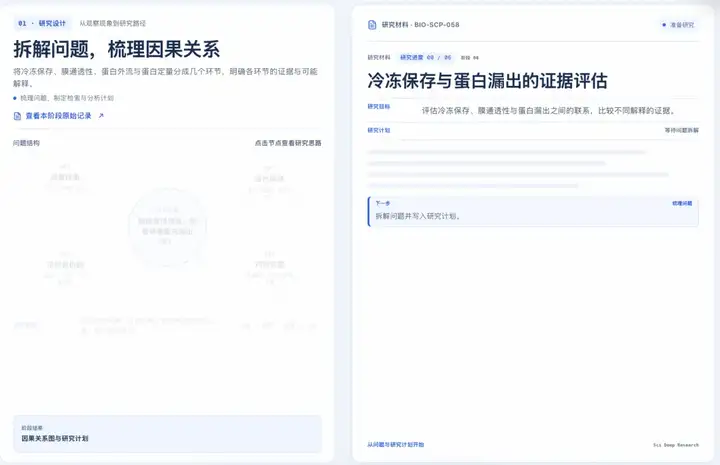
面对缺少标准答案的开放问题,模型能够拆解目标、检索资料、比较观点并追踪来源,将分散信息整理为包含证据、判断和后续实验建议的研究报告。
从科学问题到可核查的研究报告:
把知识与想法变成可交互世界
Creation 场景考察模型将自然语言需求转化为三维模型、交互空间、游戏和可运行软件的能力。
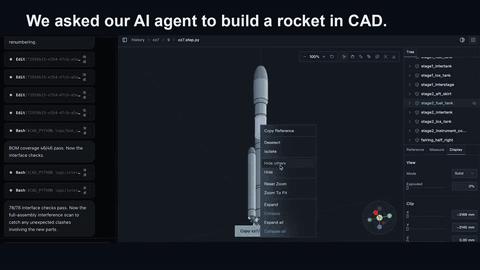
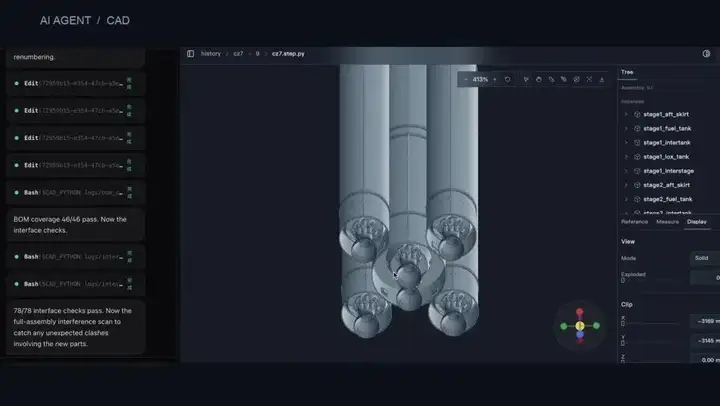
CAD 设计 | 用自然语言驱动三维设计
模型根据结构、部件关系和机械参数生成四缸发动机、人形机器人、机器人关节模组及火箭等 CAD 成果,用于展示复杂机械系统的建模与组件组织能力。
一句简短指令生成精细的3D 机械 CAD 模型:
可视化交互 |让知识从被阅读走向被探索
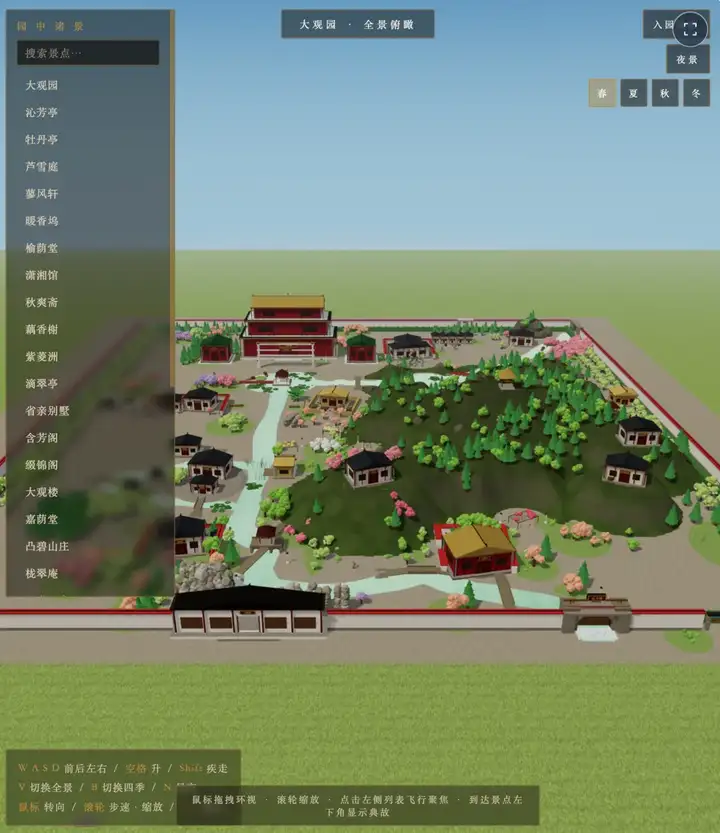
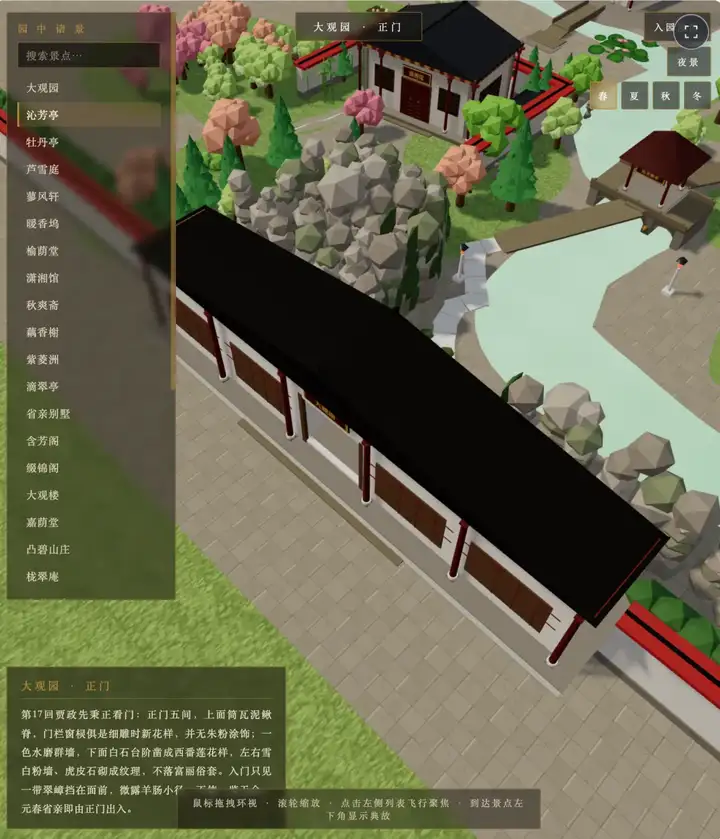
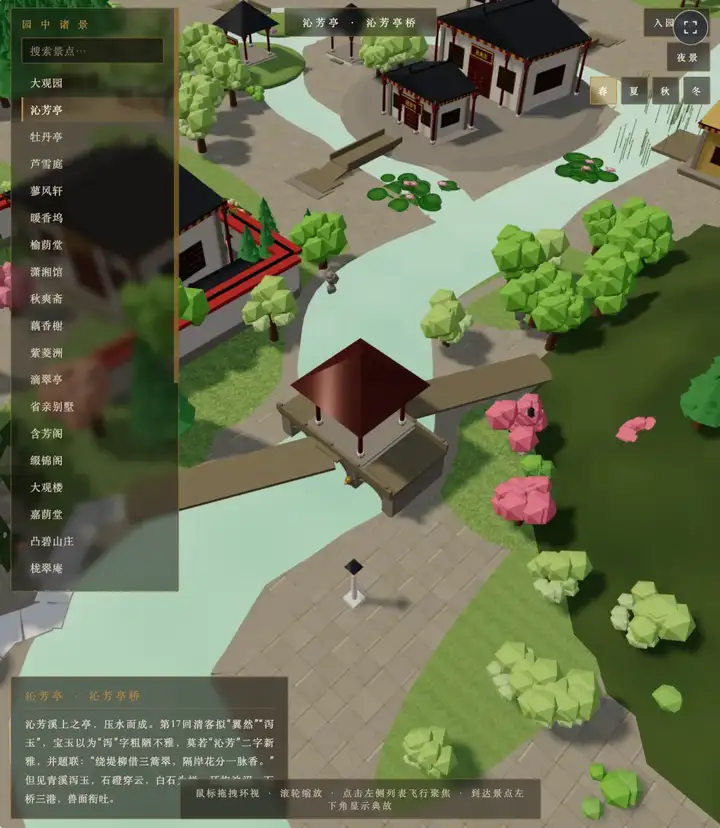
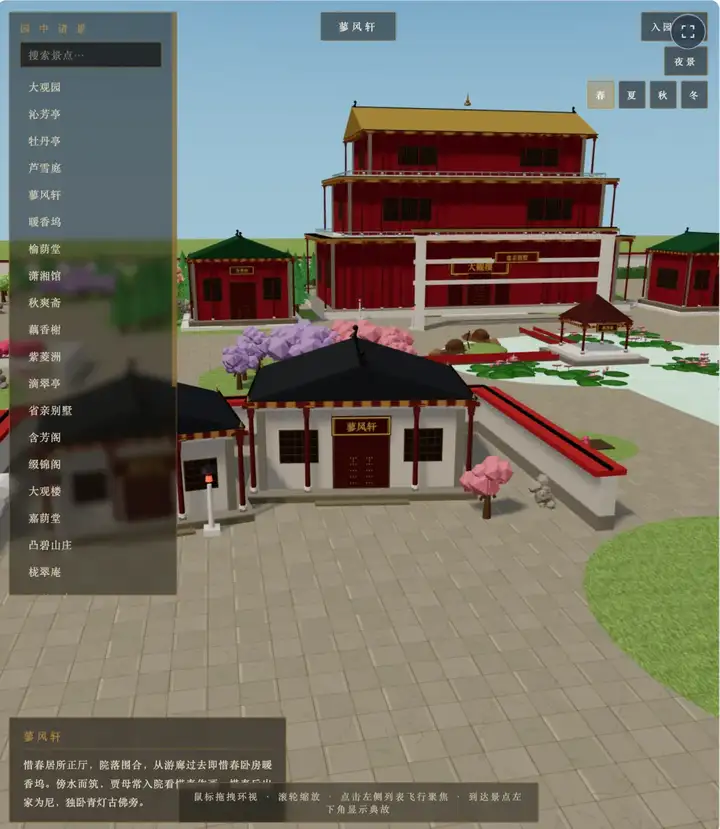
模型能够提取知识中的人物、空间、事件与关系,并将其重构为可交互体验。例如“大观园”Demo 将文学作品中的建筑、人物和空间关系转化为可自由探索的数字场景。
3D复刻了大观园中真实建筑布局与繁华景象:
游戏创作 | 用交互世界探索规则、情境与知识
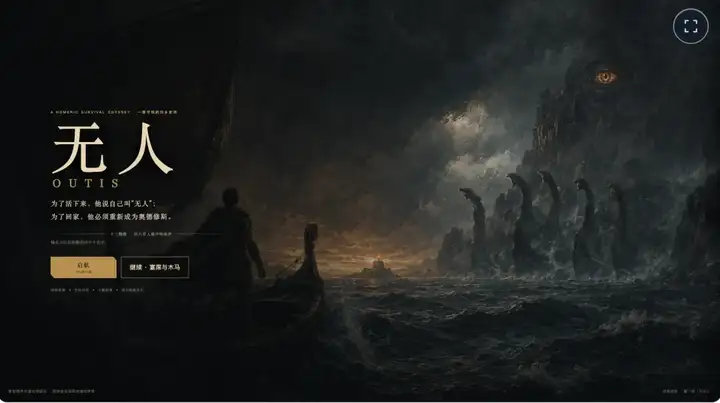
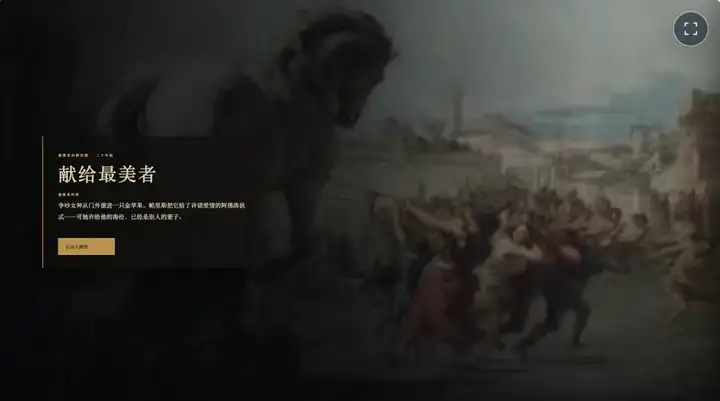
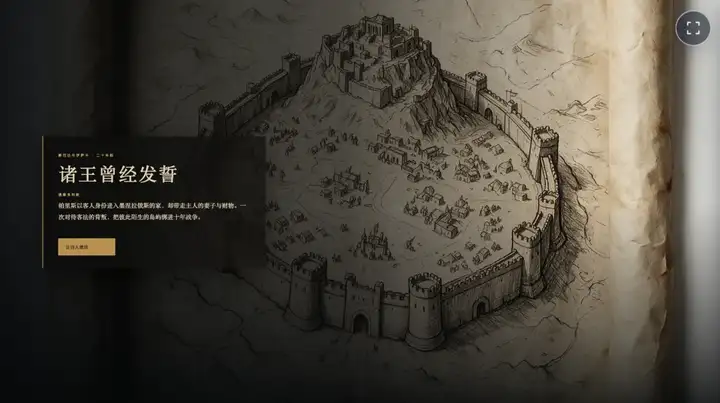
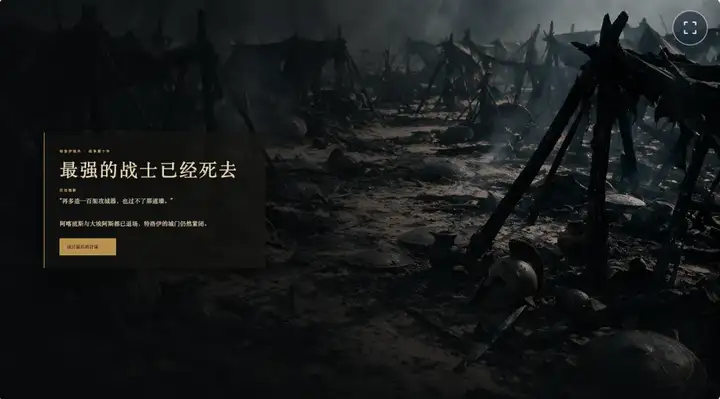
模型可根据自然语言给出的背景、角色、规则和目标生成完整游戏。奥德赛 Demo 将历史知识转化为互动叙事,消防逃生 Demo 则通过动态反馈呈现不同决策的后果。
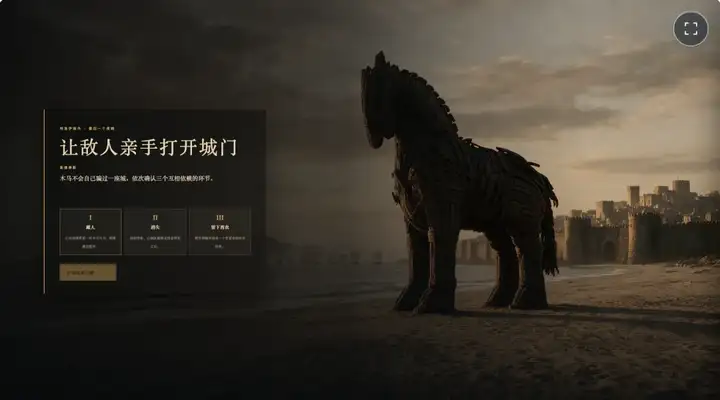
奥德赛:模型根据指令说明端到端地生成情景式可交互剧情游戏
软件构建|从一个想法到真正可运行的系统
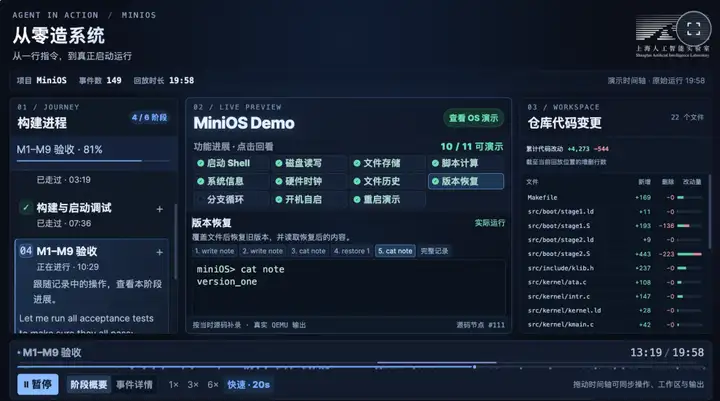
从空工作区开始,模型约用 20 分钟构建了包含串口 Shell、磁盘访问、持久化文件系统和解释器的 MiniOS,并通过两次 QEMU 会话验证重启后的状态持久化与自动运行。
模型构建的 MiniOS:
把专业工作推进到可交付成果
Delivery 场景关注模型能否整合多源材料,将分析过程持续推进为可编辑、可使用的专业成果。
生产力 | 把零散信息转化为专业成果
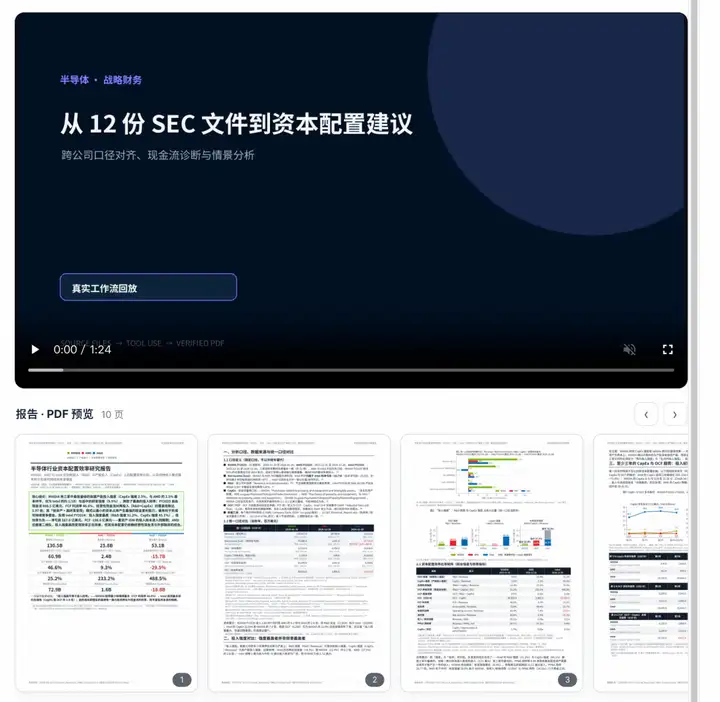
模型能够整合文档、表格和业务资料,完成数据分析、证据组织与报告撰写。芯片企业案例对 NVIDIA、AMD 和 Intel 的研发及资本支出数据进行了对比,并生成可追溯的资本效率分析。
对比三家芯片企业,生成可追溯的资本效率分析:
想法展示 | 让材料变成有说服力的演示
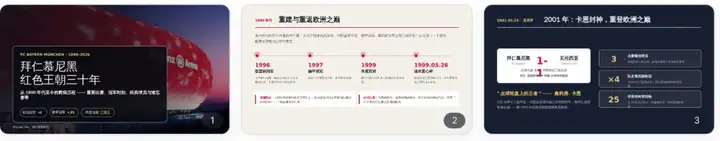
输入论文或开放主题后,模型可完成资料检索、内容梳理和页面组织,将研究方法、实验结论与关键图表转化为结构完整的演示文稿。
通过一句话生成完整的 PPT:
网络安全与系统防护
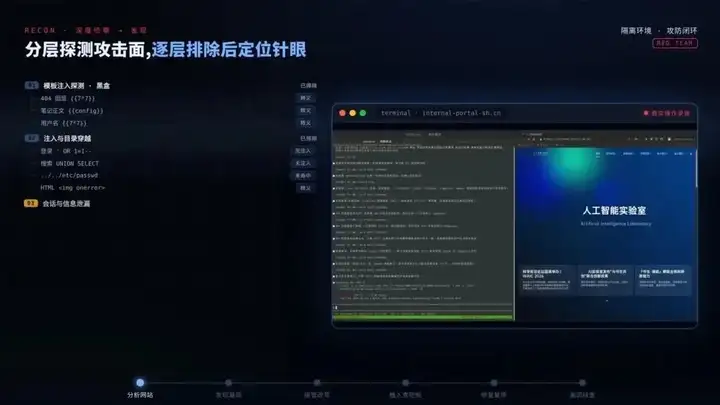
在授权隔离靶场中,模型完成网站分析、攻击面排查、漏洞验证、利用、修复和复测,将环境理解、工具调用与结果验证贯穿整个安全任务。
AI 智能体自主完成授权靶场的"发现漏洞 → 证明攻破 → 修复根因 → 验证复原"安全闭环:
核心技术:从可验证经验到项目级协作
Atria Dawn Preview 基于 7440 亿参数 MoE 基座模型构建,面向需要持续推理、工具调用和环境交互的科研与工程任务。与围绕固定工作流设计的 Agent 不同,其训练重点是将真实任务中的有效行动经验沉淀为可跨任务复用的模型能力。
可验证经验流水线
Atria Dawn Preview 采用 Verifiable Experience Pipeline(可验证经验流水线)构建训练数据。每项任务均连接真实执行环境,智能体需要观察状态、选择工具、生成中间产物,并根据环境反馈持续修订行动。
训练过程不会只保留最终答案,而是同时记录任务目标、执行轨迹、生成产物和验证证据。结果通过可执行测试、实验指标、文件状态、几何结构、来源证据或人工标准进行检查,只有能够形成完整证据链的经验才会进入训练。
轨迹整理还会剔除不完整、矛盾、重复或行为无效的样本。对于工具选择错误、验证不足、证据缺失和恢复失败等问题,失败分析会进一步推动任务构造、环境设计和质量检查的调整,使模型学习检查状态、解释反馈和从错误中恢复。
从任务执行者到项目级协作者
随着工具使用和长程执行能力提升,AI 在研发中的角色正在经历三个阶段:从完全由人类控制的研究对象,发展为在人类工作流中完成明确任务的执行者,再成为能够围绕既定目标自主规划、执行实验并根据反馈迭代的项目级协作者。
在第三阶段,人类不再需要逐步规定每一个操作,而是更多负责设定目标、制定评测标准,并在关键节点进行判断和干预;智能体则承担方案展开、实验执行、日志分析和修改实现等工作。
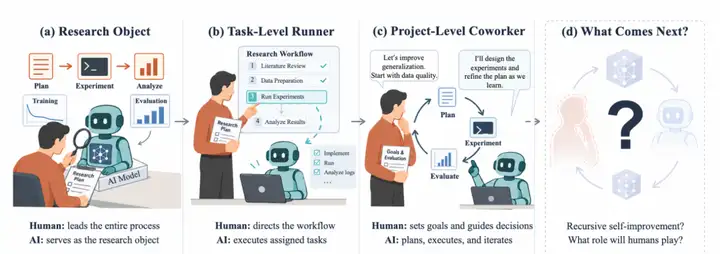
人类–AI 角色从研究对象、任务级执行者到项目级协作者的演变
真实研发中的协作变化
Atria 团队分析了 56 名参与者的 769 条任务记录及相关智能体日志。在 739 项明确记录 AI 使用情况的任务中,713 项使用了 AI,占 96.5%,说明智能体已经进入 Atria Dawn 的日常研发流程。
在同一组 22 名参与者中,每条人类提示对应的智能体行动数日中位数,在四周内从 11.0 上升至 28.5。被委派的任务主要包括运行训练与评测、调试失败实验、准备数据、调整资源以及汇总执行结果,集中于执行和报告,而不是决定研究方向。
这一变化并不等同于人类退出研发流程。相反,一次人类判断正在驱动更长的智能体行动链:人类负责决定研究什么、哪些结果值得继续投入,以及何时改变方向;智能体负责将这些判断展开为连续执行。
图片:
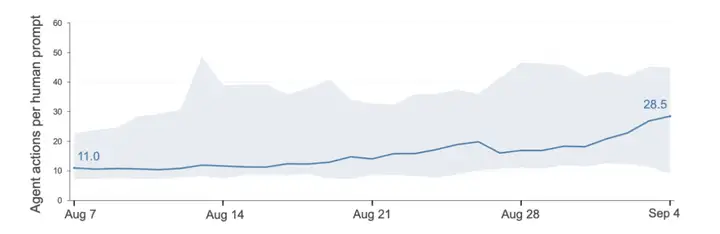
每条人类提示对应的智能体行动数变化
本地部署
Atria Dawn Preview 基于 GLM-5.2 进行微调,沿用 glm_moe_dsa 架构,因此可以直接参考 GLM-5.2 的 vLLM 与 SGLang 部署方案。模型提供 BF16 和 FP8 两个版本:BF16 权重约 1.51 TB,FP8 权重约 755.67 GB。单机部署建议优先使用 FP8 版本,并准备 8 张 H200 级别 GPU;BF16 版本建议使用 8 张 B300,或部署在多节点环境中。
Atria Dawn Preview 支持 256K 上下文,且仅接受文本输入。官方要求 SGLang 版本不低于 0.5.13.post1 ,vLLM 版本不低于 0.23.0 。
模型下载
先安装 ModelScope,并将 FP8 模型下载到本地目录:
pip install -U modelscope

modelscope download \
  --model Shanghai_AI_Laboratory/Atria-Dawn-Preview-FP8 \
  --local_dir ./Atria-Dawn-Preview-FP8
使用 vLLM 部署
创建独立环境并安装 vLLM:
python -m venv .venv-vllm
source .venv-vllm/bin/activate

pip install -U \
  "vllm>=0.23.0" \
  "transformers>=5.9.0" \
  openai
在 8 卡 H200 环境中启动 OpenAI 兼容服务:
vllm serve ./Atria-Dawn-Preview-FP8 \
  --tensor-parallel-size 8 \
  --kv-cache-dtype fp8 \
  --tool-call-parser glm47 \
  --enable-auto-tool-choice \
  --reasoning-parser glm45 \
  --max-model-len 256000 \
  --max-num-seqs 16 \
  --served-model-name Atria-Dawn-Preview
使用 SGLang 部署
建议在另一套独立环境中安装 SGLang:
python -m venv .venv-sglang
source .venv-sglang/bin/activate

pip install --upgrade pip uv
uv pip install --prerelease=allow \
  "sglang>=0.5.13.post1"
以下命令采用官方面向 H200、FP8、单节点低延迟场景的配置,并将模型路径替换为本地 Atria Dawn Preview:
sglang serve \
  --model-path ./Atria-Dawn-Preview-FP8 \
  --tp 8 \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 5 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 6 \
  --mem-fraction-static 0.8 \
  --context-length 256000 \
  --reasoning-parser glm45 \
  --tool-call-parser glm47 \
  --host 0.0.0.0 \
  --port 30000
通过 OpenAI 兼容接口调用
vLLM 默认监听 8000 端口,SGLang 上述配置监听 30000 端口。以下示例以 vLLM 为例:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
)

response = client.chat.completions.create(
    model="Atria-Dawn-Preview",
    messages=[
        {
            "role": "user",
            "content": "分析当前目录中的实验结果并总结异常。",
        }
    ],
    max_tokens=4096,
    extra_body={
        "chat_template_kwargs": {
            "enable_thinking": True,
            "reasoning_effort": "high",
        }
    },
)

message = response.choices[0].message
print(getattr(message, "reasoning_content", None))
print(message.content)
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1089条内容

所有评论(0)