最懂科学的开源基础大模型『书生-S2』发布:科学能力比肩顶尖闭源,通用性能居开源第一梯队
9月13日,在2026浦江创新论坛(第十九届)人工智能赋能科学研究专题论坛上,上海人工智能实验室(上海AI实验室)发布书生多模态大模型 S2(以下简称“书生-S2”)。重点提升了长程科研能力与智能体能力,并通过创新架构设计探索科学专业知识的持续扩展,为长周期科研任务提供更坚实的能力基础。
书生-S2在知识、代码、智能体等通用能力上达到了开源模型第一梯队,同时在Biology-Instructions、Mol-Instructions等生命科学和材料结构理解、生成与设计相关的科学任务评测上表现优异,大幅领先其他开闭源旗舰模型。不仅如此,书生-S2还能稳定有效地执行研究级的严谨数学推理和调研等科研长程任务。在IMO-Proof、AdvancedMathBench等强调长程严谨推理的竞赛数学与高等数学基准上,书生-S2整体领先现有开源模型,并达到Gemini 3.1 Pro等顶尖闭源模型的水平。
书生-S2已与昇腾计算生态开展深度协同,围绕计算、通信、显存等进行深度优化,持续探索从模型能力提升到国产算力基础设施优化的协同演进路径。书生-S2即将接入『书生·端砚』科学发现平台,为平台进一步提供科学专业、长程科研与智能体能力支撑,推动模型能力融入真实科研任务与科研流程。
- 体验链接:
https://chat.intern-ai.org.cn/ - GitHub链接:
https://github.com/InternLM/Intern-S1 - ModelScope链接:
https://www.modelscope.cn/models/Shanghai_AI_Laboratory/Intern-S2-397B - 温馨提示:
- 书生大模型对所有用户都开放了一定额度的免费API,欢迎大家使用,如需更高额度可以提交申请,详情见:https://internlm.intern-ai.org.cn/api/strategy;
- 书生-S2-Preview-397B将于2026年10月31日下线,请及时将调用模型改为书生-S2以获得最佳体验。
架构创新:让专业知识持续接入大模型基座
科学知识始终处于持续演进之中,新的发现、研究方法和任务不断涌现,而不同学科的细分方向又有着各自的专业知识、数据规律和任务要求。模型完成训练后,知识与能力也相对固定,难以随着新任务实时更新。若针对每个新方向重新训练整个模型,不仅成本高昂,也可能影响原有的通用推理、指令遵循等能力。
如何在保留原有综合能力的同时,让模型的专业领域知识得到持续扩展?针对这一问题,书生-S2通过Memory Decoder引入可插拔的专业记忆,为科学基座提供了一种灵活的领域能力扩展方式。
不同领域的专业知识可以通过独立的记忆模块进行学习,并在不修改主模型参数的情况下接入书生-S2。在回答具体问题时,模型能够根据当前内容动态协调主模型与专业记忆的贡献,让领域知识参与完整的科学问题求解。
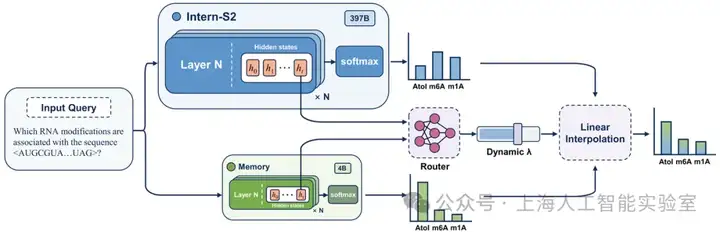
书生-S2模型架构
这种设计,让模型能够更加灵活地适应不断更新的专业领域需求。面对新的研究方向、数据和任务规范,只需针对相应领域训练专业记忆模块,即可将新的知识与任务能力接入已有基座,而无需重新训练整个模型。由此,模型原有的通用理解与推理能力得以保留,专业能力则可以根据实际需求持续补充。
在生物领域,这一路径已经获得实验验证。接入Intern-MemDec-4B后,书生-S2在覆盖DNA、RNA、蛋白质及生物分子相互作用等方向的Biology-Instructions 评测中,平均成绩由56.92提升至60.32。这一提升幅度已接近书生-S1-Pro到书生-S2在同一任务上的跨代提升,展现出专业记忆进一步释放科学基座领域潜力的价值。
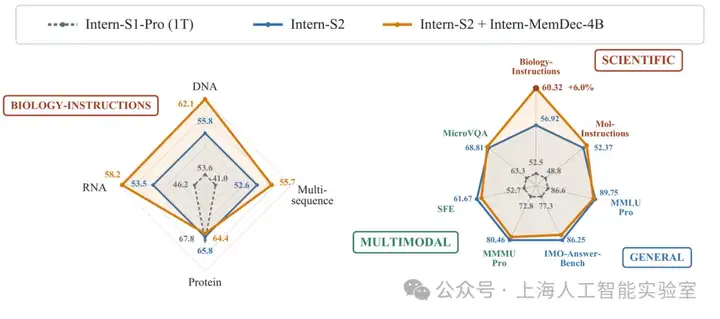
书生-S2中MemDec模块引入后效果对比
专业能力的扩展并未以牺牲通用能力为代价。跨领域评测显示,接入生物记忆后,模型在部分其他科学及多模态任务上的表现有所提高,通用知识、推理和多模态能力总体保持在与主模型接近的水平。专业记忆带来的能力扩展,能够与基座原有的综合能力协同发挥。
这种协同对于真实科研尤为重要。科研问题往往同时需要专业判断与通用推理:理解研究对象只是起点,后续还需要整合上下文、比较不同解释、分析证据,并提出可验证的方案。科研人员也会在同一会话中持续追问,从一个专业判断逐步深入到更复杂的分析与推演。
在这一过程中,主模型与专业记忆可以共同参与回答,使领域知识融入完整的推理过程,在同一会话中兼顾专业判断与通用分析,更好地应对复杂科学问题。
从生物领域出发,Memory Decoder为科学基座的持续演进提供了可扩展的接口:让新的专业知识不断接入,让已有的通用能力持续发挥作用,为不断变化的科研需求提供更灵活的智能支撑。
能力进阶:从深度思考到自主执行
在保持通用能力位列第一梯队的基础上,书生-S2持续强化科学专业能力,并进一步提升了长程思考和智能体能力,为驱动长周期的科研任务奠定坚实基础。
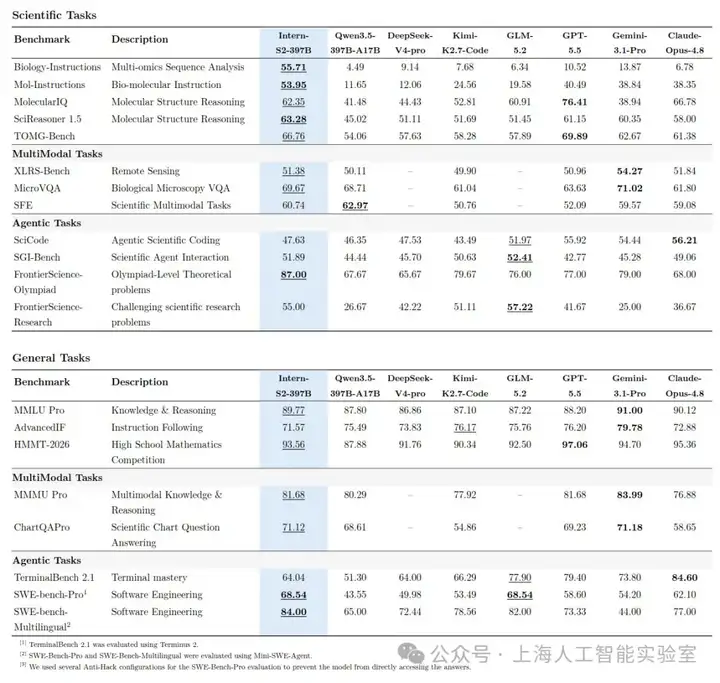
书生-S2综合评测结果
如上图所示,书生-S2 在知识、代码、智能体等通用能力上达到了开源模型第一梯队,在 Biology-Instructions、Mol-Instructions 等生命科学和材料结构理解、生成与设计相关的专业任务评测上表现优异,大幅领先其他开闭源旗舰模型。
不仅如此,书生-S2 还能稳定有效地执行研究级的严谨数学推理和调研等科研长程任务。在 IMO-Proof、AdvancedMathBench 等强调长程严谨推理的竞赛数学与高等数学基准上,书生-S2整体领先现有开源模型,并达到Gemini 3.1 Pro 等顶尖闭源模型的水平,在部分指标上实现超越。
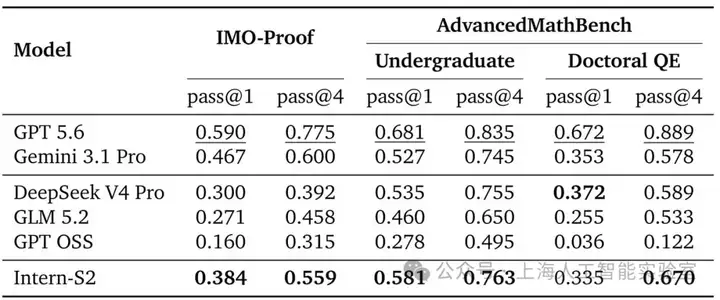
书生-S2竞赛数学和高等数学评测结果
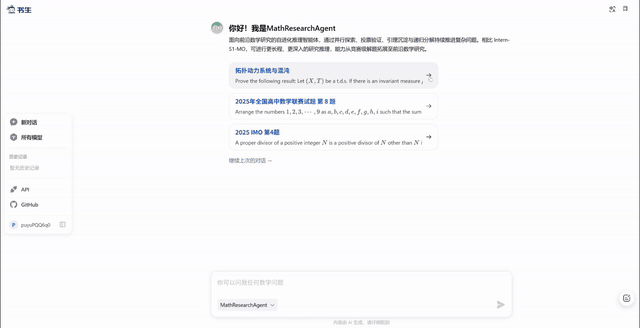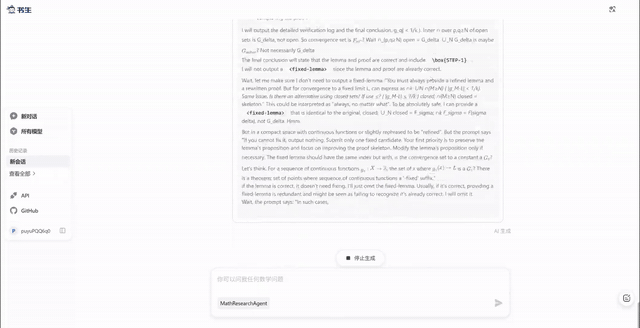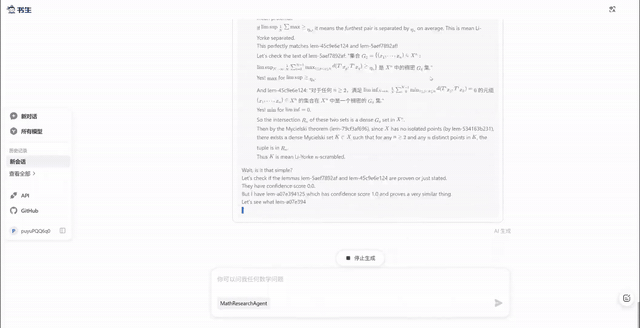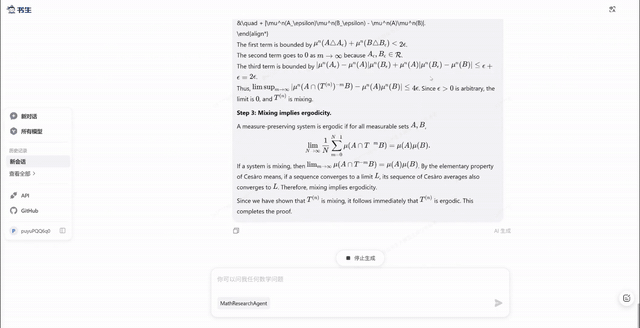
以最新数学博资考题为例,书生-S2可以围绕一道复杂问题进行数小时的持续探索、推理与验证,并最终形成简洁、严谨的解答。
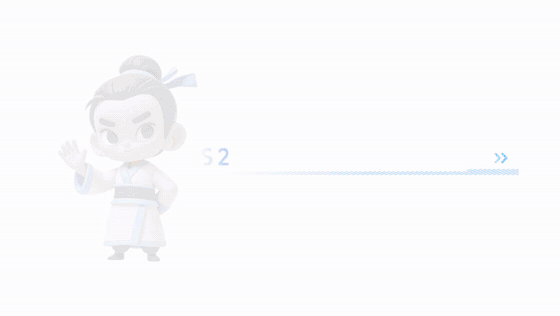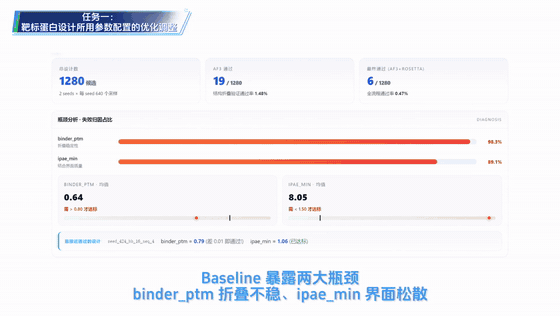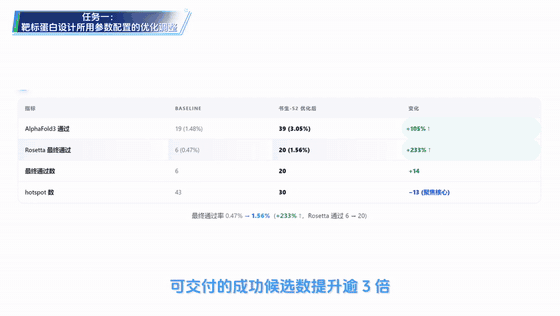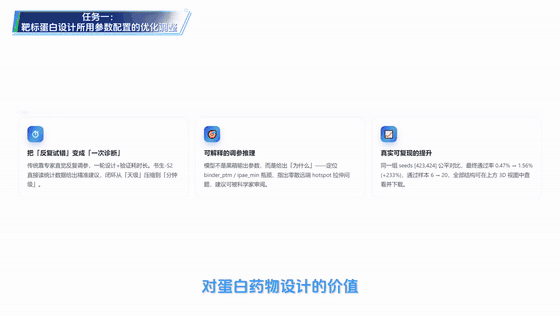
以免疫治疗靶点IL-7Rα的蛋白结合剂设计为例,书生-S2可以围绕分子设计持续进行分析、推理与优化,并结合实验反馈不断调整策略,最终获得更高质量的候选分子。
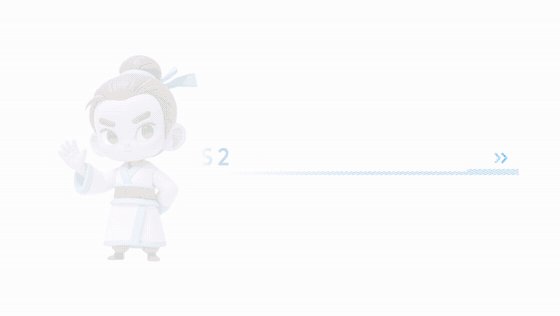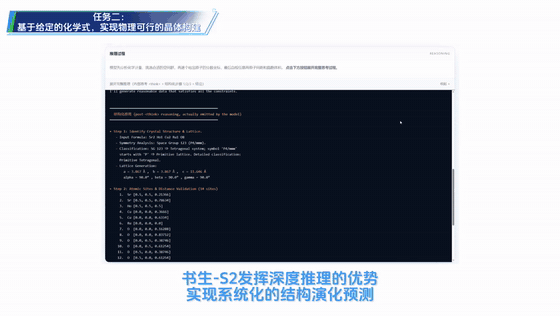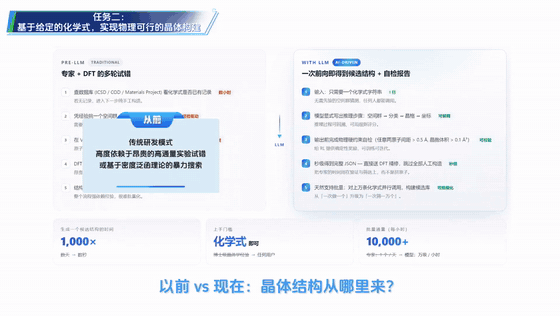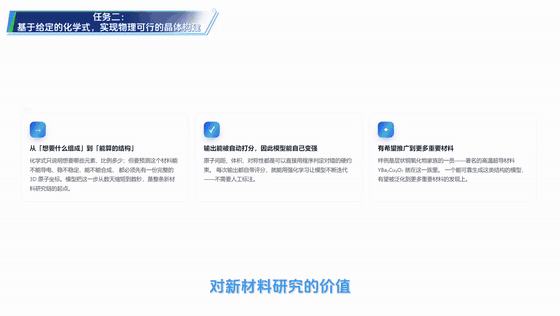
以五元氧化物Sr₂Ho₁Cu₂Ru₁O₈的晶体结构构建为例,书生-S2可以根据输入化学式,结合晶体学知识自动完成空间群匹配,并从晶格参数、晶胞体积到原子分数坐标进行系统化构建,将复杂的晶体结构探索从经验试错转向模型驱动,为后续计算与实验验证提供更精准的起点。
而当任务进一步从“解决一个问题”扩展到“完成一件复杂的事情”,模型需要具备更强的智能体能力:理解任务目标,自主进行任务拆解,选择合适的工具,完成多工具协作,并根据不断获得的信息组织和调整后续步骤。不只是回答问题,而是把复杂事情做成,这正是书生-S2智能体能力的核心体现。
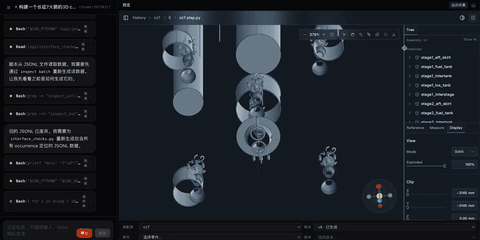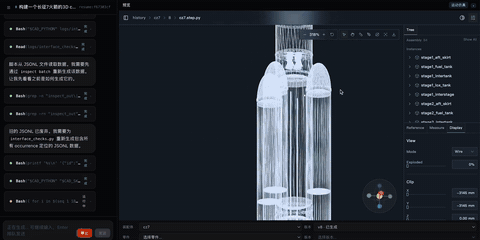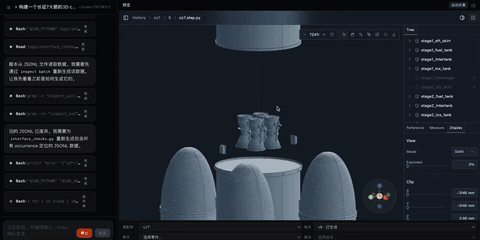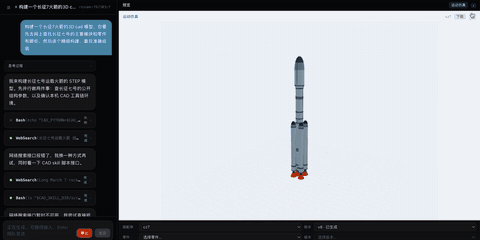
例如,用户只需输入一句“帮我构建一个长征7火箭的3D CAD模型”,书生-S2便能理解构型参数与装配关系的完整需求,自主完成信息检索、任务拆解与方案编排,将多个步骤串联起来,最终生成完整的三维模型。
从能力到发现:把科学推理送入可验证闭环
模型能力的提升,为AI进一步参与真实科研流程提供了更坚实的基础。但对于复杂科研任务而言,完成一次推理或给出一个答案并不是终点,真正的科学发现还需要经历持续推理、计算分析、证据核验与实验验证。
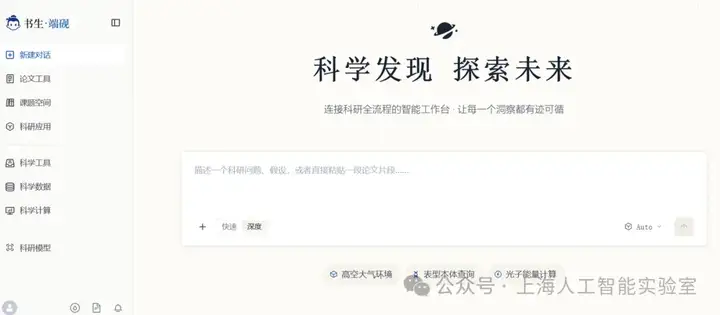
基于书生大模型,上海人工智能实验室打造了书生·端砚科学发现平台。平台通过连接科学大模型、专业智能体、实验装置与具身自动化设备,提供覆盖从“假设提出”到“实验验证”完整科研流程的全栈能力。平台以模型与Science Harness协同驱动复杂科研任务,通过可信科研证据链让研究过程可核验、可复现,并进一步连接真实实验资源,让AI提出的方案能够进入实验现场,依据真实反馈持续调整研究路径。
目前,书生·端砚已在生命科学、关键材料、半导体、核聚变、量子、地球气象等六大核心科研领域落地。其中在蛋白质、新材料等前沿研究中,书生·端砚完成了干湿实验闭环,实现了科学发现全流程端到端验证。
随着书生-S2即将接入,其科学专业、长程科研与智能体能力将进一步融入书生·端砚的科研任务组织、可信验证与真实实验环节,为AI持续参与复杂、长期的科研任务提供更强的模型基础。
架构探索:从Next Token到Next Concept
书生常常把语言模型的生成当成一场由局部到整体的“接龙游戏”——但真正的智能,不只局限于“下一个 Token”的逐字推演。如果让大模型在生成每一个词之前,先在更高的语义抽象层进行“概念级”的规划与预测呢?
基于这一设想,上海AI实验室将在后续正式推出全新的探索成果:首个在万亿级Token规模上完成预训练的隐空间语言模型(latent-space language model)——NCP-ArchPreview。
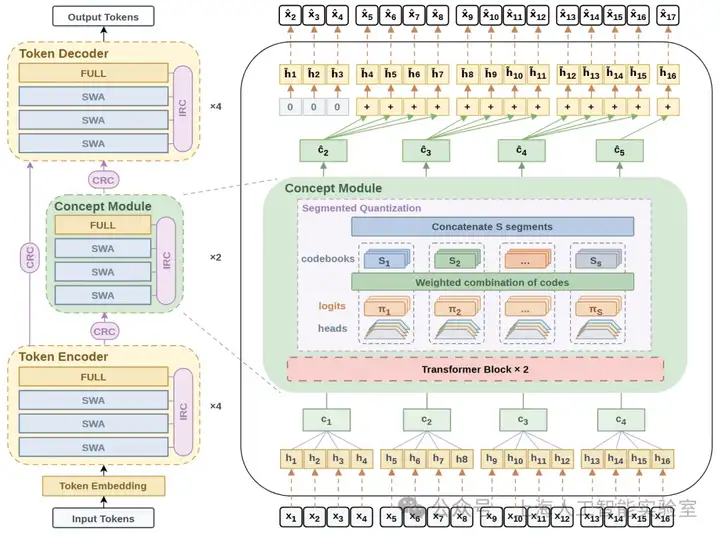
NCP-ArchPreview模型架构
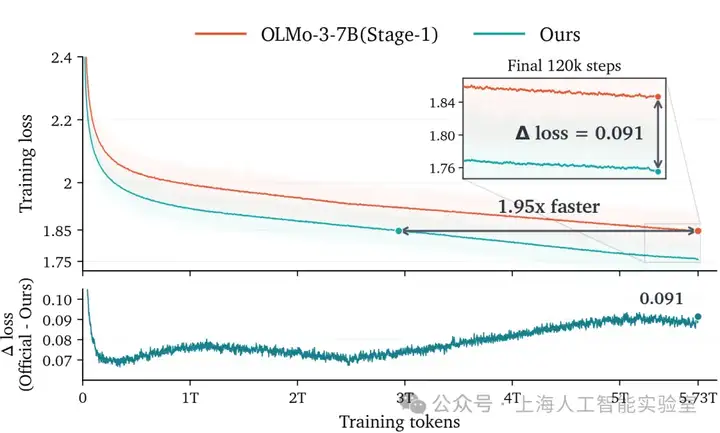
NCP-ArchPreview预训练Loss
- 全新的JEPA式隐空间预训练任务Next Concept Prediction:不仅关注当前 Token,更通过专设的Concept Module预测隐空间中跨Token的离散语义概念,反哺指导底层自回归生成。
- 大幅提升的训练收敛效率:在5.73T Token的预训练中,NCP-ArchPreview仅消耗同规模基准51.3%的数据量即追平其最终收敛Loss(实现1.95×收敛加速);并在下游评测中全面领先(如GSM8K +5.99)。
- 更轻量、更高上限的推理效率与下游生态:借助隐空间表征,NCP-ArchPreview能天然赋能推测解码(Speculative Drafting)加速,提升draft接受率;也能以全新的方式实现轻量化领域自适应:仅需使用少量数据微调隐空间表征上17M的参数,即可大幅提升目标领域表现。
下一代隐空间语言模型基座的大门已经推开,部分中间权重与适配代码已经提前开放,欢迎社区抢先体验与探索。完整的技术细节与全面开放计划即将揭晓,敬请期待!
- 模型权重与Checkpoints:https://huggingface.co/collections/ArchSpace-Collection/ncp-archpreview
- LMDeploy推理部署支持:https://github.com/InternLM/lmdeploy
- 评测与vLLM推理:https://github.com/LUMIA-Group/
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐


 0
 0
- 0


 已为社区贡献1086条内容

所有评论(0)