NeuG v0.2.0:以事务为基础,面向规模化的结构、语义与关键词统一检索
NeuG v0.2.0 在事务一致性之上统一图遍历、向量检索和全文检索。三种检索共用一份数据,通过 Cypher 组合;代码以 Apache 2.0 开源。
请关注加星:https://github.com/alibaba/neug
Agent 应用离不开检索,而检索有三种诉求
Agent 应用要检索的对象各不相同:私有文档、代码库、智能体的长期记忆,或是商品、工单、日志。但要做的事是一致的:在需要的时候把相关信息准确捞回来。拆开看,每次检索背后通常包含以下诉求:
- 要沿实体之间的关系走,判断谁和谁有关、中间隔几跳,即结构查询。
- 换了个说法,也要把语义相关的内容找出来,即语义查询。
- 搜的是专有名词、产品型号、API 名,一个字都不能错,即关键词查询。
三种诉求对应三种检索能力,但要把它们装进同一个应用并不容易。我们以智能体记忆管理为例,调查了市面上主流的开源系统,问题集中在三类:
- 检索能力凑不齐。 如 Mem0:v2.0.0 起把外接图数据库划到商业版,开源版不再提供图遍历;剩余后端里只有约一半实现关键词检索(BM25),切到不支持的后端就降级为纯语义。想凑齐三种能力得自己接。
- 三种检索都有,但是拼出来的。如 Cognee:开箱同时跑三套文件级存储(内嵌图库 Ladybug、向量库 LanceDB、SQLite)。三种检索都支持,但数据要跨引擎同步、检索要跨系统对齐,运维和效率都不是最优。
- 同一引擎支持三种检索,但性能吃紧。如 Graphiti:以 Neo4j 为后端,本身提供向量、全文、图三种索引,但实测随数据规模增大检索性能明显下降。
NeuG v0.2.0 想解决的就是这个问题:在事务一致性保障下,用一个开源引擎提供三种检索,并在数据规模增长时保持查询性能。第 04 节给出了实际系统中的质量和性能测试结果。
事务一致性之上的三种检索
向量检索(HNSW)、全文检索(FTS/BM25)和图遍历要共用一份数据,首先要保证它们读到同一个版本。Agent 的记忆和知识会持续写入;如果图结构已经更新,向量或全文索引还停留在旧状态,查询结果就不可靠。
NeuG 的读事务固定在一致的数据快照上;写事务提交时,图数据和相关索引变更一起发布。结构、语义和关键词检索因此读取同一份已提交数据,不需要应用层在多个后端之间额外对齐。在原有事务机制之外,v0.2.0 增加了两部分能力;
统一索引框架。 引入通用的 StorageIndex 框架,向量索引和全文索引共享同一套生命周期,用同一组 CREATE INDEX DDL 管理,并和图存储挂在同一份数据上,不需要"内容在向量库、关系在图库"的复制与对齐。
其中,HNSW 由 zvec 以原生 C++ 静态链接进引擎、零拷贝访问,不是在通用存储外面再套一个向量扩展。
一条 Cypher 组合检索。 向量距离算子、bm25() 全文算子、图模式匹配可以在同一条查询里编排,粗筛、重排、关系扩展一次写完,混合与融合在引擎内部完成,不必在应用层拼装或跨系统 JOIN。
这些功能都包含在 NeuG 的开源版本中,使用 Apache 2.0 协议。NeuG 本身是嵌入式的,pip install neug 即可使用,无需额外部署;从笔记本上的原型到线上服务,使用的是同一个引擎和同一套 API。
下面用一个真实的知识问答场景,看三合一的检索如何落地。
一个真实场景:给 NeuG 自己的代码库做知识问答
想解决的问题。 我们希望基于 NeuG 自有的代码库、产品文档和 Wiki,构建一个知识问答助手。这类问答通常涉及三种检索能力:基于函数调用与依赖关系的结构化检索,基于源码和文档切片生成的向量检索,以及面向 LLM 生成 Wiki 的全文检索。
这正是一个需要同时融合图、向量和全文检索的典型场景。如上文所述,传统方案往往需要借助多套数据系统分别承载这些能力,不仅架构复杂,也增加了数据同步和运维成本。
现在,这些索引都可以在 NeuG 数据库中统一构建和管理。 首先对代码库进行抽取:通过 AST 提取函数、类等符号节点,以及调用、继承等关系边(如 function-call-function、class-inherit-class),构建符号级代码图;
随后利用 Leiden 社区发现算法识别概念边界,并由 LLM 为每个社区生成对应的 Wiki 内容;最后,将 Wiki 内容及其与函数、代码片段之间的对应关系写回同一张图。由此,代码结构、语义向量和文档内容都能统一承载于同一个引擎和同一份数据之上。
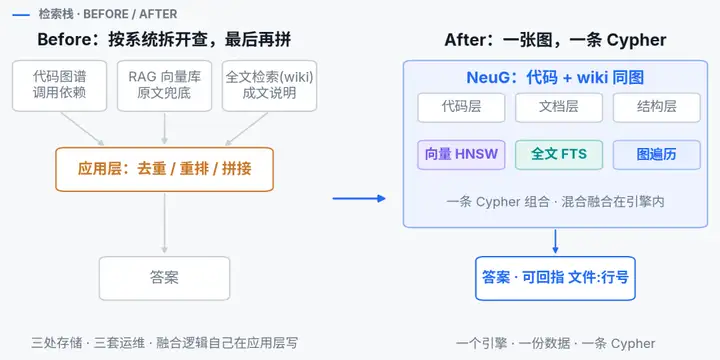
知识库场景的简化图 Schema 如下:
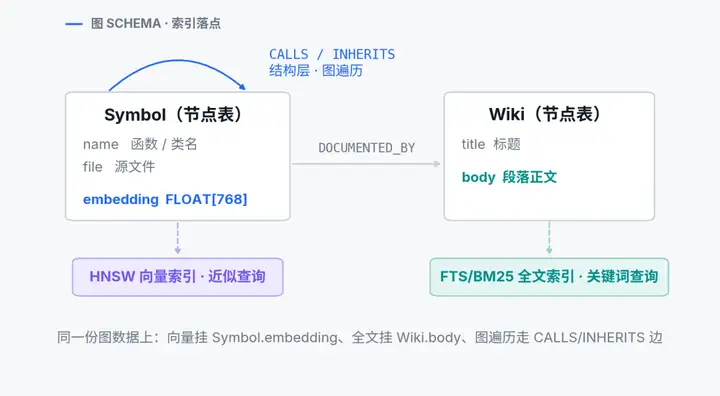
基于这份 Schema,三类检索对应的数据与索引如下:
| 检索类型 | 针对哪类数据的查询 | 用的索引 | 典型问题 |
|---|---|---|---|
| 结构查询 | 结构层 INHERITS / CALLS / DOCUMENTED_BY 边 | 图遍历 | 有哪些实现 StorageIndex 的子类 |
| 语义查询 | 代码层 Symbol 的语义向量 | HNSW | 如何通过索引做语义检索、而不做全表扫描 |
| 关键词查询 | 文档层 Wiki 的正文 | FTS / BM25 | Wiki 里是怎么介绍 StorageIndex 这个类的 |
语义查询:模糊提问也能召回,并且有索引优化
用户看到 v0.2.0 发布了索引优化,提问"如何通过索引做语义检索、而不做全表扫描?"NeuG 靠 HNSW 向量索引召回语义最接近的几个函数:
-- 给代码节点的语义向量建一次 HNSW 索引
CREATE INDEX call_vec ON Symbol USING HNSW (embedding)
WITH (metric = 'cosine', m = 16, ef_construction = 200);

-- 找与问题向量最接近的 5 个函数
MATCH (c:Symbol)
RETURN c.name, c.file
ORDER BY vector_distance_cosine(c.embedding, $query_vec) ASC
LIMIT 5;
跑这条 Cypher 时,NeuG 不会真的把每个函数都算一遍距离再排序取前 5。优化器识别出 ORDER BY 向量距离 + LIMIT 这个 TopK 组合,把整段扫描改写成 HNSW 索引扫描,直接问索引要最近邻。
召回结果排第一的,正是负责这条自动改写的 HNSWIndexScanOptimizer(extension/vector_search/src/hnsw_index_scan.cc)。你问"如何利用索引",返回的第一条就是"让查询走上索引的那段代码"。
关键词查询:精确命中讲 "StorageIndex" 的那段 wiki
用户想进一步了解索引优化背后的设计:StorageIndex 框架具体怎么设计?直接用语义向量查询容易把它和 index、index scan 等概念混在一起,因此靠 BM25 一个字不差地命中:
CREATE INDEX wiki_fts ON Wiki USING FTS (body);

MATCH (w:Wiki)
RETURN w.id, w.title, bm25(w.body, 'StorageIndex') AS score
ORDER BY score ASC
LIMIT 5;
命中的是 wiki 关于"统一索引框架"的段落:各类索引作用在同一份图数据上、共用同一套生命周期,向量与全文只是它的两种实现,详见下图:
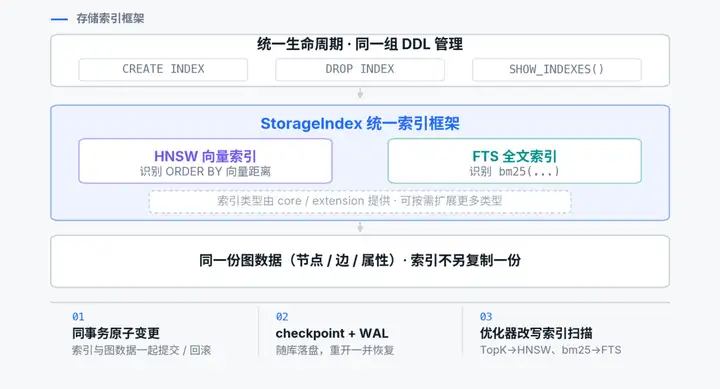
存储索引框架架构:统一 DDL 生命周期 → StorageIndex 框架(HNSW / FTS 两类实现)→ 同一份图数据;底部为三点工程保证
到这里,"三种检索为何能共用一份数据、又都走上索引"有了答案;但框架对应哪个类、有哪些实现,wiki 只讲到设计层。
结构查询:顺着边走,从 Wiki 到基类、再到实现
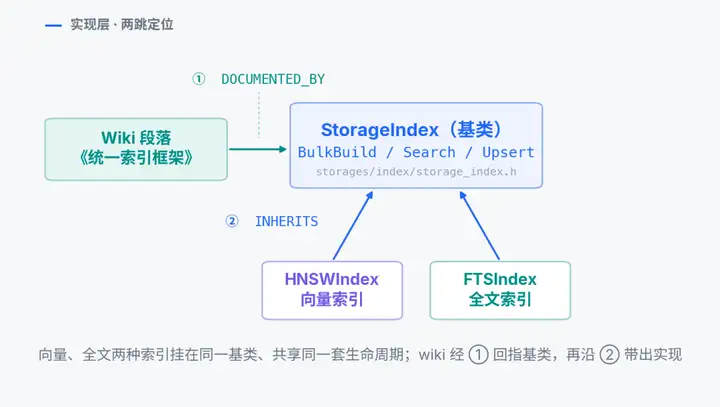
用户看完设计还想确认具体实现:这套框架对应哪个类?有哪些类实现了它?这一步不用猜关键词,直接在图上遍历。每段 wiki 导回图时都用 DOCUMENTED_BY 连到它对应的代码符号,反向走这条边回到基类;
再沿继承边 INHERITS 走一跳,实现它的子类就都出来了:
-- 第一跳:从命中的 wiki 段落反向走 DOCUMENTED_BY,回到它对应的基类
MATCH (w:Wiki {title: '统一索引框架'})<-[:DOCUMENTED_BY]-(base:Symbol)
-- 第二跳:再沿继承边 INHERITS 反向走,找出所有继承(实现)它的子类
MATCH (impl:Symbol)-[:INHERITS]->(base)
RETURN base.name, base.file, collect(impl.name) AS implementations;
两跳走完,答案一次给全(见下图):基类 StorageIndex 之下挂着向量索引 HNSWIndex 与全文索引 FTSIndex,共享同一套生命周期。这是"检索三合一"在实现层的地基:两种索引同一个基类、三路检索同一份数据,不是三套东西拼在一起。
三合一:一条 Cypher,把"机制 + 出处 + 调用链"一起带回
真实问答常常同时要这三样:先在代码层按语义粗筛候选函数,跨 DOCUMENTED_BY 到文档层带回 wiki 出处、用 BM25 把最相关段落排到前面,再沿结构层的 CALLS 补一段下游。
在按系统拆开的架构里,这是三次跨系统查询加应用层手写融合;在一张图里,它就是一条 Cypher:
-- Step 1: 向量粗筛,取语义最近的 20 个函数
MATCH (c:Symbol)
WITH c
ORDER BY vector_distance_cosine(c.embedding, $query_vec) ASC
LIMIT 20
-- Step 2: 带回 wiki 出处,用 BM25 对候选段落重排
MATCH (c)-[:DOCUMENTED_BY]->(w:Wiki)
WITH c, w, bm25(w.body, $keyword) AS s
ORDER BY s ASC
LIMIT 5
-- Step 3: 沿调用边把下游函数一并带出
MATCH (c)-[:CALLS]->(d:Symbol)
RETURN c.name, w.title, collect(d.name) AS downstream;
结构、语义、关键词在同一张图、同一条查询里一次拿全,读取的是同一个已提交数据快照。每个答案还能顺着边回指到具体文件和行号,便于核对和复现。
验证:在真实系统里的质量、性能评测
这一节以智能体记忆管理为例,选市面上主流的三款开源产品 Mem0、Cognee、Graphiti,做 with / without NeuG 的对照评测。先看三款产品及其三路检索(向量 / 全文 / 图遍历)能力现状:
- Mem0:社区最活跃的智能体记忆框架之一,默认把记忆存进向量库(qdrant)。支持向量检索;全文检索仅约一半后端实现 BM25、其余降级为纯语义;图遍历自 v2.0.0 开源版不再提供。
- Cognee:把数据加工成"知识图谱 + 向量"的记忆引擎,默认同时驱动三套存储:图库 Ladybug、向量库 LanceDB、关系库 SQLite。三路检索都支持,但全文是读回内存现算 BM25、非引擎索引。
- Graphiti:用知识图谱承载智能体长期记忆的框架,默认后端 Neo4j,三路检索都支持。
实验方式:把每款产品的默认后端换成 NeuG,再与它内置的默认后端对照。 同一份数据、同一套流程、同一个 LLM,系统内唯一变化的是后端。下面从质量、性能两个维度看实测结果。
- 质量维度:LoCoMo,272 sessions、1540 题,qwen-plus 答题 + qwen-max 判分,比问答准确率;
- 性能维度:LongMemEval-M,51,661 sessions,向量 / 全文 / 向量全文 hybrid / 图结构 4 类查询各 50 题,比 p50 检索延时。
评测结果1:质量维度,换 NeuG 后端准确率基本持平。 先看小库(LoCoMo,272 sessions)上把各家默认后端换成 NeuG 后的问答准确率:
| 系统 | without NeuG | with NeuG | 质量 Δ |
|---|---|---|---|
| Mem0 | 0.4786 | 0.4786 | 打平 |
| Cognee | 0.661 | 0.650 | -1.1pp |
| Graphiti | 0.4526 | 0.4455 | -0.71pp |
结论:三家准确率全部打平(差异都在噪声带内),换后端没有牺牲质量;换来的是检索栈收敛到一个引擎,不必维护多套后端、也不用在应用层手写三路融合。
评测结果2:性能维度,规模上来差距才拉开。 性能测试使用 LongMemEval-M 的 51,661 sessions,比质量测试的数据规模更大。数据量增长后,索引是否由引擎原生维护,开始带来数量级的差异。我们继续对三个产品做 with / without NeuG 对照,比较 4 类查询的 p50 检索延时:
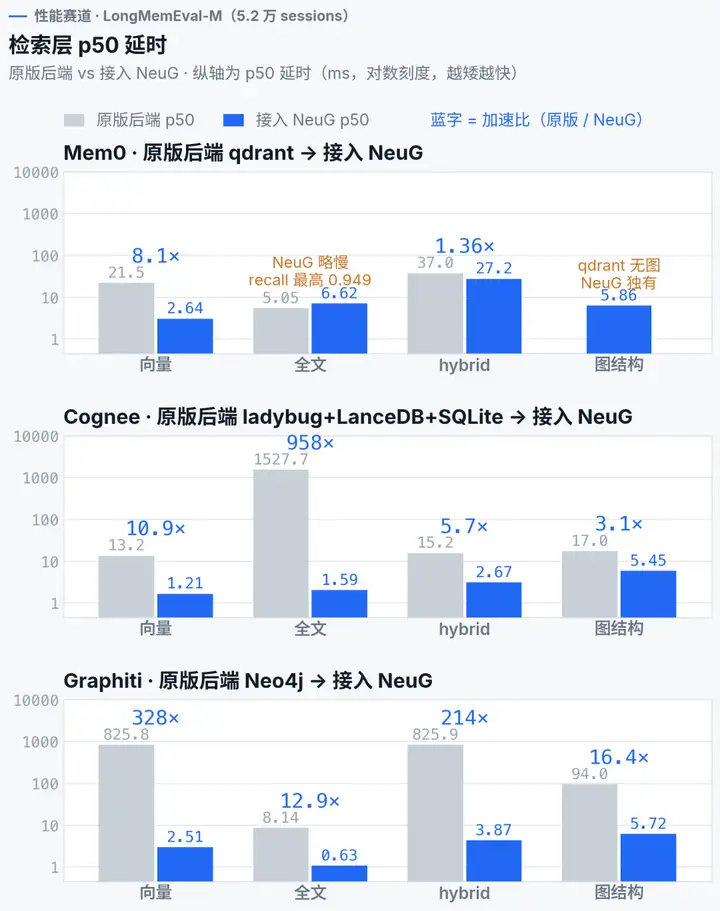
接入 NeuG 后,三个产品的四类查询都有提升:向量快 8.1–328××、全文快 12.9–958×、hybrid 快 1.36–214××、图结构快 3.1–16.4×。
Mem0 的全文检索:NeuG 略慢于 qdrant(6.62ms vs 5.05ms),但 recall 更高(0.949 vs 0.897),且 Mem0 原本使用的 qdrant 没有图能力,接入 NeuG 后图结构查询耗时为 5.2ms。
数据量增长时,这些检索由 NeuG 一个引擎完成。
上手
pip install neug==0.2.0
from neug import Database

db = Database("my_knowledge_graph")   # 嵌入式:进程内运行,无需独立服务
conn = db.connect()

# 安装仅第一次需要
conn.execute("INSTALL vector_search");
conn.execute("INSTALL fts");

conn.execute("LOAD vector_search")
conn.execute("LOAD fts")

# 代码层:函数 / 类节点,带语义向量;结构层:function-call-function 调用边
conn.execute("""
    CREATE NODE TABLE Symbol (
        id INT64, name STRING, file STRING, embedding FLOAT[768],
        PRIMARY KEY (id))
""")
conn.execute('COPY Symbol FROM "symbols.json"')
conn.execute("CREATE REL TABLE CALLS (FROM Symbol TO Symbol)")
conn.execute('COPY CALLS FROM "calls.jsonl" (from="Symbol", to="Symbol")')
# 文档层:回导入图的 wiki 段落;用 DOCUMENTED_BY 把段落链回它讲的函数
conn.execute("CREATE NODE TABLE Wiki (id INT64, title STRING, body STRING, PRIMARY KEY (id))")
conn.execute('COPY Wiki FROM "wiki.json"')
conn.execute("CREATE REL TABLE DOCUMENTED_BY (FROM Symbol TO Wiki)")

# 一次索引:代码向量走 HNSW,wiki 正文走 FTS/BM25
conn.execute("CREATE INDEX call_vec ON Symbol USING HNSW (embedding) WITH (metric='cosine')")
conn.execute("CREATE INDEX wiki_fts ON Wiki USING FTS (body)")

# 一条 Cypher,向量 + 全文 + 图遍历组合检索($ 参数以 parameters 传入)
rows = conn.execute("""
    MATCH (c:Symbol) WITH c
    ORDER BY vector_distance_cosine(c.embedding, $query_vec) ASC LIMIT 20
    MATCH (c)-[:DOCUMENTED_BY]->(w:Wiki)
    WITH c, w, bm25(w.body, $keyword) AS s ORDER BY s ASC LIMIT 5
    MATCH (c)-[:CALLS]->(d:Symbol)
    RETURN c.name, w.title, collect(d.name)
""", parameters={"query_vec": query_embedding, "keyword": "StorageIndex"})
NeuG v0.2.0 在现有事务机制之上加入统一索引框架,把结构、语义和关键词检索放进同一个引擎。性能测试覆盖了 51,661 sessions,相关代码已经在 Apache 2.0 协议下开源。
如果你正在为 Agent 应用选择存储和检索引擎,可以直接安装 NeuG 试用。
- GitHub:https://github.com/alibaba/neug
- NeuG 主页:https://neug.io
- NeuG v0.2.0 完整 release notes: https://github.com/alibaba/neug
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐


 0
 0
- 0


 已为社区贡献1086条内容

所有评论(0)