登录社区云,与社区用户共同成长
邀请您加入社区
为遵守国家网络实名制规定,未绑定将限制内容发布与互动
Speridlabs 正式开源 Iris-3B,这是一个 3B 参数的像素空间图像生成模型:不经过 VAE 压缩与解码,直接生成 RGB 像素,支持约 100 万像素的多种宽高比图像。它可按提示词生成摄影、插画和设计素材;同一骨干网络分别微调后,还可实现单目深度估计、图像修复与 4 倍超分辨率。 文生图基座、深度模型和修复/超分模型的权重及代码均以 Apache 2.0 协议开放。3
当前,大模型正在获得更长的推理链、更复杂的工具调用能力和更高的任务完成上限。但在软件工程与科学研究中,生成一份新答案并不等于获得了新的可靠结论:修复补丁可能引入回归,数学候选可能掩盖局部反例,物理推导也可能越过其适用条件。真正需要回答的问题,是新增计算结果何时有资格取代已有状态,并成为下一轮推理的可信起点。 清华大学深圳国际研究生院智能机器人实验室VeriLoop团队围绕这一问题发布开源模型Ver
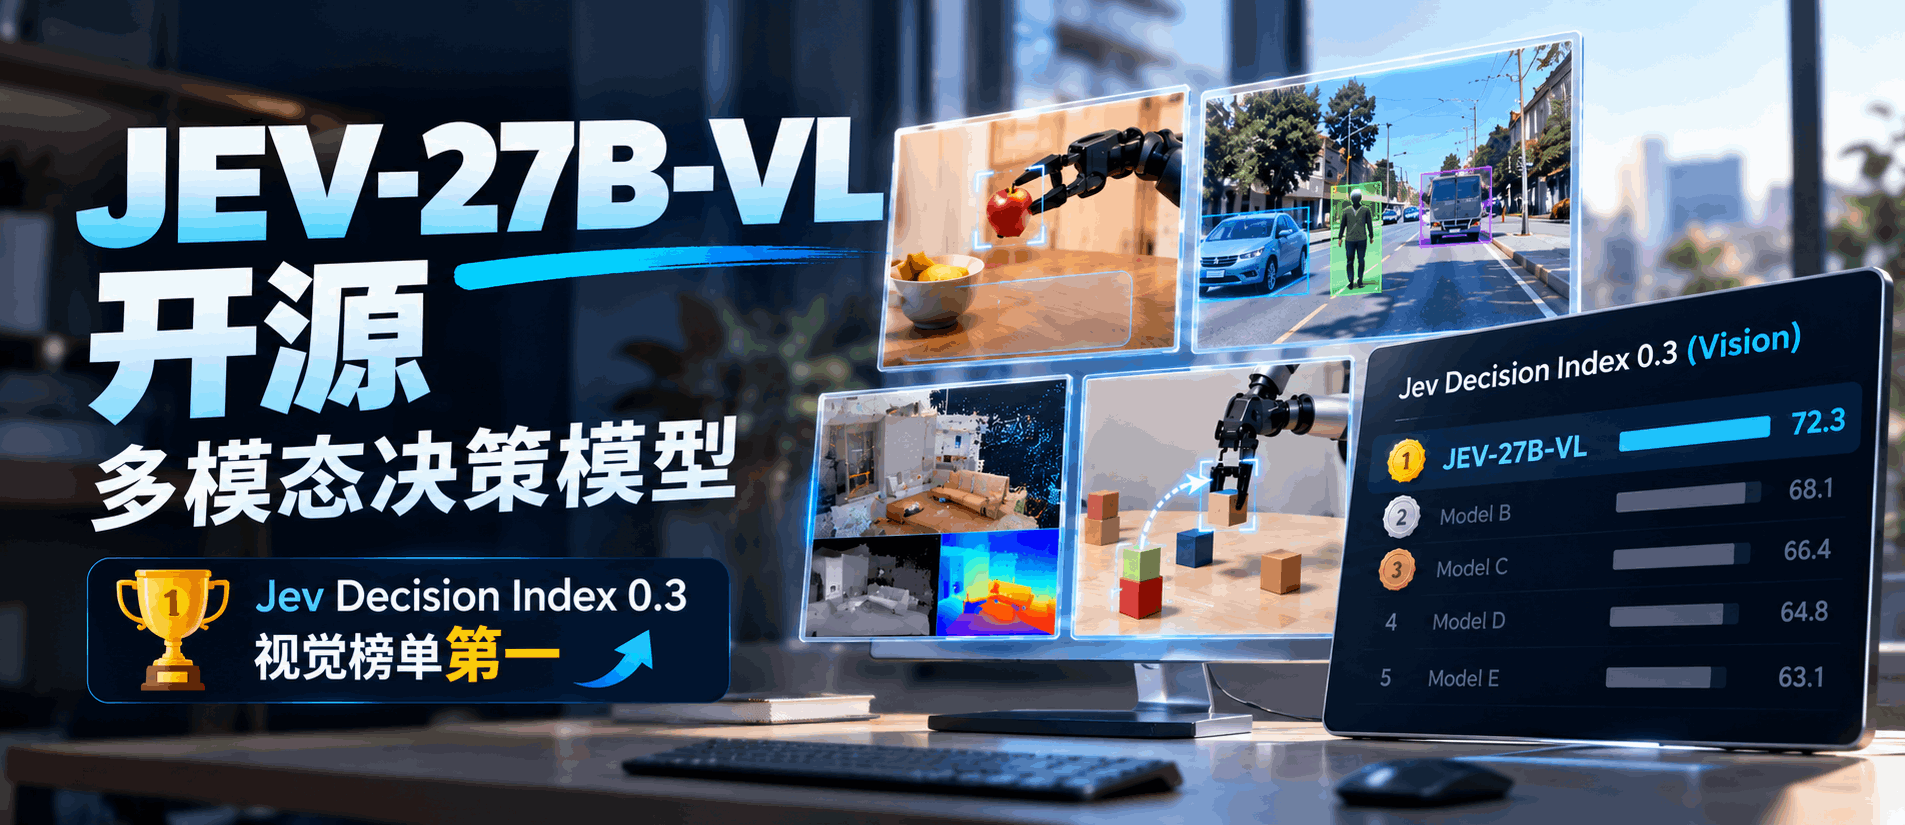
AutoTrust AI Lab 开源 JEV-27B-VL,一款基于 Qwen3.8-27B 的多模态决策模型。它可以视为能“看见”的 JEV-27B:沿用原有的 System 1 决策与 System 2 推理能力,并将其扩展至图像输入。 System 1 可在单次前向传播中完成 yes/no 判断、2–256 个选项选择和 0–5 评分,并输出校准概率;System 2 则保留 Qwen3.
一句弹幕里的“狒瘾犯了”,换成英文还能让人接住梗吗?一段视频换了语言,能否听到自然的配音?一本小说翻到后半本,人物的名字还能保持一致吗? 哔哩哔哩Index LLM团队推出 Index-Translate 多语言翻译模型家族。文本模型覆盖包括中文、英文在内的 150 种语言,提供 2B、9B、35B-A3B(preview) 三种规模;Index-Echo、Index-Homura 和 Index
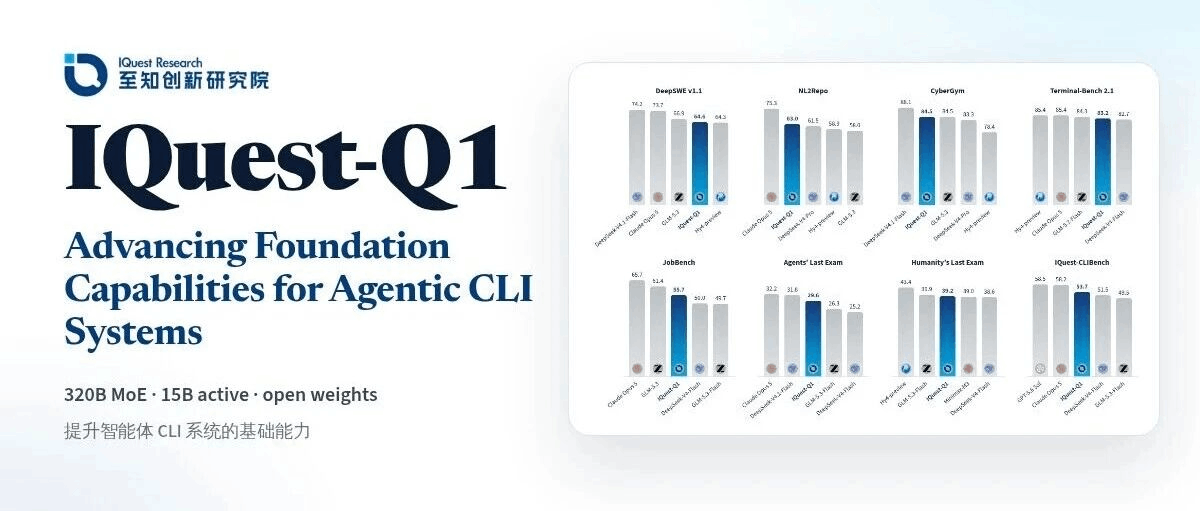
至知创新研究院开源 IQuest-Q1—— 一款定位于提升智能体 CLI 系统的基础能力的智能体基座模型。它采用稀疏 MoE 架构,总参数 320B、激活 15B,上下文 524,288 token;训练在合成环境中进行:任务与环境一并合成,同一策略在多种脚手架中训练(保留各脚手架原生的工具与上下文管理,只有策略自身的错误才作为学习信号),四个专家模型再由多教师在线策略蒸馏(MOPD)整合进同一学
近日,上海人工智能实验室(上海AI实验室)推出决策模型书生·明决(Decision),性能超越Jev及同类开源模型,包含0.8B、2B、4B三档参数版本。 智能体在动态环境执行任务时,决策的速度与精度,直接决定交互的质量与任务落地的效果。书生·明决将原生视觉感知与指令遵循融为一体——在“看见”画面的同时做出精准决断。实测显示: 单卡4090环境中决策速度达30次/秒:书
9 月 23 日,斯坦福大学与 NVIDIA Research 联合团队发布 Contrastive Language Models(CLM),一类用对比学习目标训练的System One决策模型。首发版本 CLM-8B 用一个状态编码器加一个动作编码器,把当前状态与候选动作映射进同一嵌入空间,按余弦相似度打分,直接充当零样本动作分类器和验证器:骨干是冻结的 Qwen3-8B,只训练 2000 万
训不起 2.8T 的 K3,玩够了 124M 的 nanoGPT,想试试十亿参数、万亿 token 的预训练,门槛有多高? 这类模型被广泛使用,例如经典的 Qwen 系列(Qwen2-1.5B、Qwen2.5-1.5B、Qwen3-1.7B……)。不过 Qwen 系列尽管开源了权重,却未完整公开预训练配方。而 OLMo、SmolLM 等进一步开放了数据和训练细节,但复现依然昂贵:据估计,即使只有
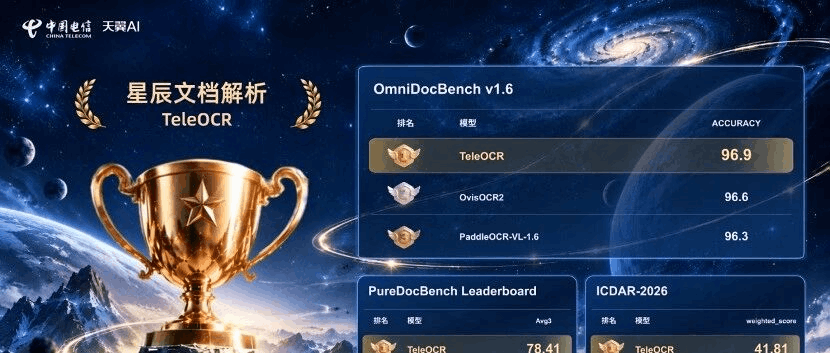
中国电信星辰通用人工智能实验室开源文档解析模型 TeleOCR。该模型采用约 1.2B 参数的轻量级视觉语言架构,在单一框架内统一处理数字文档与相机拍摄文档,并将文字、版面、表格、公式和科学图表转换为可直接使用的结构化结果。 TeleOCR 在 OmniDocBench v1.6 取得 96.87 总分,登顶 OmniDocBench v1.6 榜单,超越 MinerU2.5-Pro、Paddle
HF 珞 https://huggingface.co/jinaai/jina-ocr-v1 魔搭 慄 https://modelscope.cn/models/jinaai/jina-ocr-v1 技术报告 https://arxiv.org/abs/2609.03181 API https://jina.ai/models/jina-ocr-v1 Jina-OCR-v1正式开源! 这