NVIDIA 开源 Nemotron 3.5 Super VL:120B MoE / 12B激活,单卡智能体任务吞吐量最高提升5倍
NVIDIA 推出 Nemotron 3.5 Super VL,将推理、指令遵循、工具使用与文本、图像、文档和视频理解整合到同一模型中,面向持续运行的专用智能体工作流。模型采用混合专家(MoE)架构,总参数量 120B,每个 token 激活 12B,支持最高 100 万 token 的上下文。
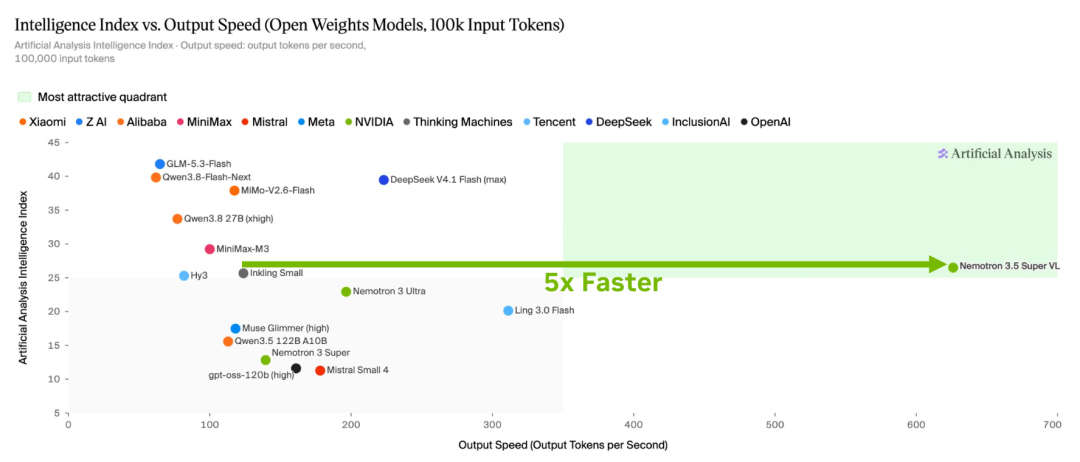
在单 GPU 上,Nemotron 3.5 Super VL 在智能体任务中的吞吐量最高可达到同等规模其他开放模型的 5 倍。在 Baseten 推理端点上,执行 Artificial Analysis Intelligence Index 智能体任务时,在 100K 输入 token 条件下,输出速度超过 600 tokens/s”吞吐量超过 600 TPS。
本次魔搭社区 day-0 支持开源有BF16和NVFP4两个版本:BF16 参考权重主要面向 SFT、RL、蒸馏、领域适配,以及生成自己的量化版本;NVFP4 版本则用于延迟与吞吐量优化的推理。
开源地址:
- 模型链接(NVFP4):https://modelscope.cn/models/nv-community/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4
- 模型链接(BF16):https://modelscope.cn/models/nv-community/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16
- 代码仓库:https://github.com/NVIDIA-NeMo/Nemotron/tree/main/usage-cookbook/Nemotron-3.5-Super-VL
专用智能体:把推理与视觉理解放进同一工作流
企业智能体不仅需要理解任务本身,还需要理解运行环境。比如,客服智能体必须遵循退货政策,研究智能体必须关联不同来源的证据,文档智能体则需要解析表格、图表与页面布局。
Nemotron 3.5 Super VL 将推理与视觉理解结合起来,以支持以下任务:
- 编程:测试和验证代码、分析错误,并提出修复建议。
- 网络研究:跨网站搜索、关联信息,并核验答案。
- 文档智能:从表格、图表和页面布局中提取信息,生成摘要与报告。
- 网络安全:识别安全漏洞,对威胁进行分级,以确定修复优先级。
- 视频理解:提取信息,用于搜索、内容审核、零售和事件分析。
在多模型系统中,Nemotron 3.5 Super VL 负责需要综合运用推理、工具使用,以及文本与视觉理解能力的专用多步骤任务。较小的 Nemotron 3.5 Lightning 负责大规模文本任务的执行,Nemotron 3 Ultra 则承担最困难的规划与编排任务。
用领域数据、工具与政策定制模型
专用智能体需要学习组织的运作方式。领域术语、工具接口、操作流程和政策要求,都会影响任务成功完成的判定标准。
网络安全、金融和医疗等行业的后训练结果:在特定生产工作流中,定制后的 Super VL 能取得超过所对比前沿模型的准确率与效率。
对于多模态数据,可参考 NVIDIANeMo Data Designer 中有关图表问答和长文档理解的资源。强化学习(RL)和基于环境的评估则可参考 NVIDIA NeMo RL 和 NVIDIA NeMo Gym。
组织可在受支持的本地、数据中心或云环境中,对模型的开放权重进行适配并部署,以满足自身的基础设施与数据需求。如需定制相关资源,请参阅 GitHub 上的 Nemotron 3.5 Super VL 使用指南。
- NVIDIA NeMo Data Designer GitHub: https://docs.nvidia.com/nemo/datadesigner/getting-started/welcome
- NVIDIA NeMo RL GitHub: https://github.com/NVIDIA-NeMo/RL
- NVIDIA NeMo Gym GitHub: https://github.com/NVIDIA-NeMo/Gym
- Nemotron 3.5 Super VL 使用指南:https://github.com/NVIDIA-NeMo/Nemotron/tree/main/usage-cookbook/Nemotron-3.5-Super-VL
智能体任务:准确率与完成效率
Nemotron 3.5 Super VL 已在 Hermes、LangChain、OpenClaw、OpenCode 和 Pi 等开放智能体,以及 Codex 和 Claude 中接受测试。除了编程任务,智能体运行框架提供方也开始采用覆盖更广泛智能体任务的专项评估。
在 Hermes Bench 和 LangChain 行为评估中,Nemotron 3.5 Super VL 的得分均高于 Nemotron 3 Ultra:
| 模型 | Hermes Bench | LangChain 评估 |
| Nemotron 3 Ultra | 56.33% | 84.3% |
| Nemotron 3.5 Super VL | 63.44% | 87.05% |
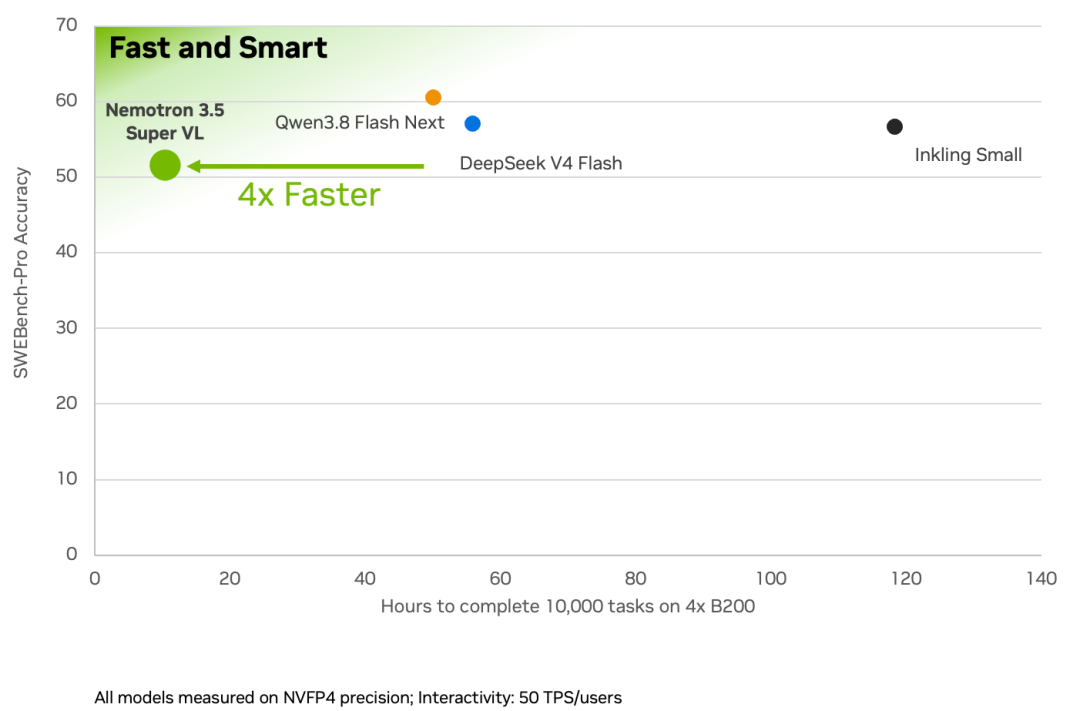
对于持续运行的智能体,效率决定一次部署能完成多少有效工作。任务完成情况取决于推理吞吐量、生成的 token 数量、工具调用次数,以及获得正确结果所需的步骤数。Nemotron 3.5 Super VL 将推测解码与共享上下文复用相结合,减少重复的提示词处理和主模型解码计算。在 NVIDIA 展示的 B200 编程任务测试中,利用更高的吞吐量与 token 效率,任务完成速度提升至 4 倍。
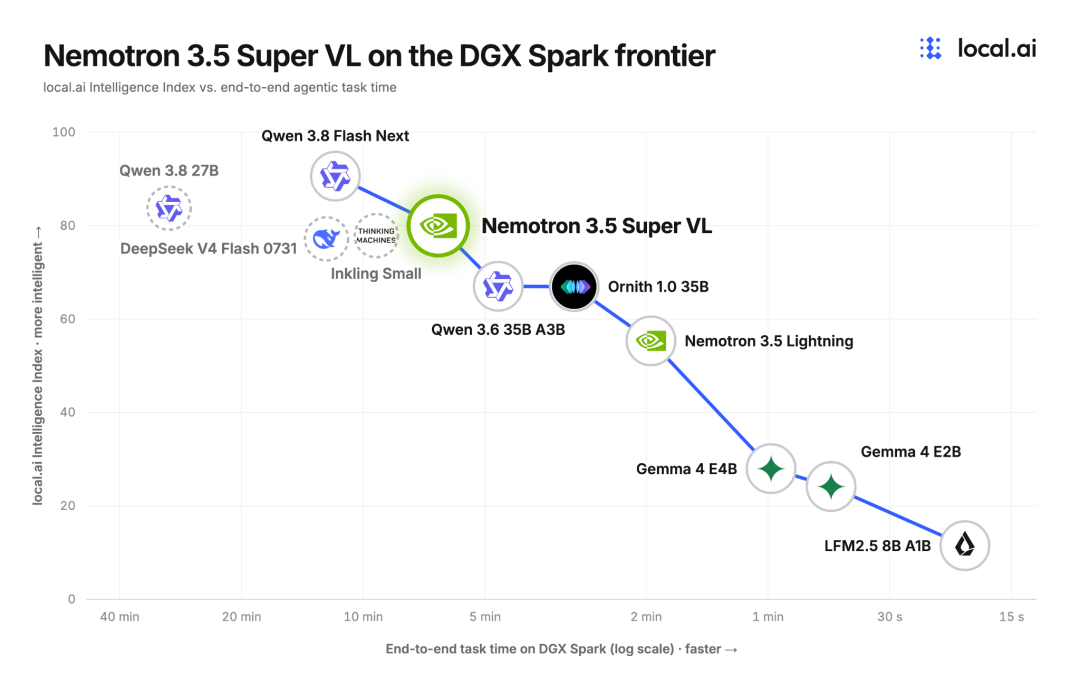
该模型还针对 DGX Spark 上的本地运行进行了优化。根据 EXO Labs 的独立评估,Nemotron 3.5 Super VL 位于准确率与任务完成效率的帕累托前沿。
底层技术:蒸馏、混合精度与上下文复用
基础模型与持续预训练
Nemotron 3.5 Super VL 由 Nemotron 3 Ultra 蒸馏而来。Ultra 的编程能力,加上蒸馏过程中使用的 SkewReverse 损失,共同帮助提升代码准确率。基于智能体轨迹、代码仓库和通用软件工程数据的中期训练,进一步增强智能体能力,使 Super VL 在多个运行框架下的 SWE-Bench 和 Terminal-Bench 测试中持续超越 Nemotron 3 Super。
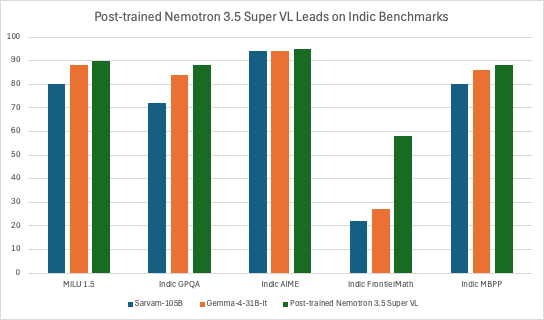
高质量自然数据与合成数据的继续预训练,提升了印度语言能力,并帮助模型在后训练后取得更高的整体得分。该阶段增加了 100 亿个印度语言 token,的 12 种语言子集和自然印度语言文本。
NVIDIA 的完整数据集涵盖 22 种印度语言、约 2.8 万亿个 token,由 NVIDIA 与印度理工学院马德拉斯分校(IIT Madras)及其 AI4Bharat 实验室合作开发。
NVFP4 与量化感知蒸馏
Super VL 使用 NVIDIA Model Optimizer 进行训练后量化和量化感知蒸馏(QAD)。NVFP4 方案在 Blackwell 上采用 4 位权重与 4 位激活;同一个检查点在非 Blackwell 平台上可采用 4 位权重与 16 位激活,并为敏感组件单独选择精度。
NVFP4 缩小模型体积,QAD 则帮助模型在较低精度下保持准确率。量化模型学习匹配原始 BF16 模型的输出,弥合量化带来的准确率差距。QAD 还使 KV 缓存能够以 NVFP4 而非 FP8 存储,同时达到准确率目标;这一过程发生在训练阶段,不增加推理开销。
多 token 预测(MTP)
MTP 为 Super VL 提供内置草稿模型,一次提出多个 token,由主模型在一次前向计算中验证。一次接受多个 token,可以减少生成响应所需的计算密集型验证步骤。专门的 MTP 增强训练阶段进一步使草稿模型与最终模型对齐。
跨智能体轮次复用上下文
智能体会反复将系统指令、工具定义和对话历史传回模型,前缀缓存可以复用这些共享输入的计算结果。
Super VL 的推理服务优化同时保留注意力缓存和 Mamba 循环状态。额外的 Mamba 状态检查点减少为推测解码恢复输入时所需的重放计算,内部检查点机制则避免在提示词处理过程中额外运行模型。
本地推理
模型下载
在具备模型访问权限的 Linux GPU 环境中安装魔搭客户端,并将 NVFP4 权重下载到本地目录:
pip install modelscope
modelscope download \
  --model nv-community/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --local_dir ./models/nemotron-3.5-super-vl-nvfp4
通过vLLM部署服务:
VLLM_USE_MODELSCOPE=true vllm serve $MODEL \
  --served-model-name nemotron-3.5-super-vl \
  --tensor-parallel-size 4 \
  --trust-remote-code \
  --gpu-memory-utilization=0.85 \
  --allowed-local-media-path=/ \
  --max-num-seqs=32 \
  --limit-mm-per-prompt '{"video": 1, "image": 1}' \
  --video-pruning-rate 0.5 \
  --media-io-kwargs '{"video": {"fps": 2, "num_frames": 256}}' \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder \
  --reasoning-parser nemotron_v3 \
  --speculative_config.method mtp \
  --speculative_config.num_speculative_tokens 3
等待服务器完成模型加载和内核编译,然后检查端点:
curl --fail http://localhost:8000/v1/models
模型训练
ms-swift day0 支持了 Nemotron 3.5 Super VL 模型的微调, ms-swift是魔搭社区官方提供的大模型训练框架,开源地址:https://github.com/modelscope/ms-swift
环境准备:
pip install git+https://github.com/modelscope/ms-swift.git
pip install git+https://github.com/modelscope/mcore-bridge.git

pip install transformers -U

# Megatron环境准备请参考以下文档
# https://swift.readthedocs.io/zh-cn/latest/Megatron-SWIFT/Quick-start.html
多模态 SFT 脚本如下
PYTORCH_CUDA_ALLOC_CONF='expandable_segments:True' \
NPROC_PER_NODE=4 \
CUDA_VISIBLE_DEVICES=0,1,2,3 \
megatron sft \
    --model nv-community/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16 \
    --dataset 'AI-ModelScope/LaTeX_OCR:human_handwrite#2000' \
    --tuner_type lora \
    --lora_rank 8 \
    --lora_alpha 16 \
    --target_modules linear_qkv linear_proj \
    --freeze_vit true \
    --freeze_aligner true \
    --vit_attn_impl sdpa \
    --tensor_model_parallel_size 1 \
    --expert_model_parallel_size 4 \
    --expert_tensor_parallel_size 1 \
    --mtp_num_layers 0 \
    --megatron_extra_kwargs '{"moe_router_bias_update_rate":0.0}' \
    --micro_batch_size 1 \
    --global_batch_size 4 \
    --num_train_epochs 1 \
    --max_length 1024 \
    --lr 1e-4 \
    --lr_warmup_fraction 0.05 \
    --min_lr 1e-5 \
    --recompute_granularity none \
    --padding_free false \
    --attention_backend unfused \
    --logging_steps 1 \
    --save_steps 200 \
    --save_safetensors true \
    --merge_lora false \
    --no_save_optim true \
    --no_save_rng true \
对验证集进行推理:
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 \
  swift infer \
  --adapters output/vx-xxx/checkpoint-xxx \
  --infer_backend vllm \
  --stream true \
  --load_data_args true \
  --enable_thinking false \
  --vllm_tensor_parallel_size 8
如果您需要自定义数据集微调模型,你可以将数据准备成以下格式:
{"messages": [{"role": "user", "content": "What is the capital of Zhejiang?"}, {"role": "assistant", "content": "The capital of Zhejiang is Hangzhou."}]}
{"messages": [{"role": "user", "content": "浙江的省会在哪?"}, {"role": "assistant", "content": "浙江的省会在杭州。"}]}
更多自定义数据格式参考文档 https://swift.readthedocs.io/zh-cn/latest/Customization/Custom-dataset.html
训练后对验证集进行推理:
CUDA_VISIBLE_DEVICES=0 swift infer \
--model output/vx-xxx/checkpoint-xxx \
--val_dataset latex_test3.jsonl \
--max_new_tokens 256 \
--temperature 0 \
--attn_impl sdpa \
--stream false
推送微调后的模型到ModelScope:
swift export \
  --adapters output/vx-xxx/checkpoint-xxx \
  --push_to_hub true \
  --hub_model_id '<your-model-id>' \
  --hub_token '<your-sdk-token>'
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐


 0
 0
- 0


 已为社区贡献1114条内容

所有评论(0)