南京大学、京东等开源 VideoJev: LVBench 73.4%,每题约 1.5 秒
长视频理解能否在保持准确率的同时,把每次决策压缩到秒级?南京大学、京东等机构的研究者提出 VideoJev,将视频时序定位与选择式视频问答统一为候选打分任务,让多模态大模型直接输出可供程序使用的结构化判断。在长视频基准 LVBench 上,VideoJev-35B-A3B 达到 73.4% 准确率,平均每题模型计算耗时 1.493 秒。相较于其 Qwen3.6-35B-A3B 基座的 Thinking 模式,实测加速约 100 倍。同一段视频上的多个问题,还可以放进一个 sequence,在一次 forward pass 中一起处理。项目已开放 4B 与 35B-A3B 两种尺寸的模型权重,以及核心训练、评测和推理代码。
魔搭模型合集:https://modelscope.cn/collections/MCG-NJU/VideoJev
代码:https://github.com/MCG-NJU/VideoJev
论文:https://arxiv.org/abs/2610.18615
项目主页:https://mcg-nju.github.io/VideoJev
视频|91 秒了解 VideoJev:从视频证据到快速决策
先看结果:长视频问答的准确率与效率
VideoJev 在 LVBench、Video-MME、LongVideoBench 和 MLVU 四个视频问答基准上进行了评测。输入仅使用视频帧,不依赖字幕或音频。结果显示,直接决策能够保留预训练多模态模型的理解能力,同时大幅减少逐词生成带来的计算。
35B-A3B:LVBench 73.4%,四项平均 79.5。其四项平均分高于 Qwen3.6-35B-A3B Thinking 的 78.8;LVBench 平均每题模型计算耗时从 149.777 秒降至 1.493 秒,约加速 100 倍。
4B:LVBench 67.9%,四项平均 74.3。平均分与 Qwen3.5-4B Thinking 的 74.9 接近,LVBench 平均每题耗时由 144.929 秒降至 1.123 秒,约加速 129 倍。相比各自基座的 Instruct 模式,两种尺寸的四项平均分分别提升 8.0 和 5.7 个百分点。
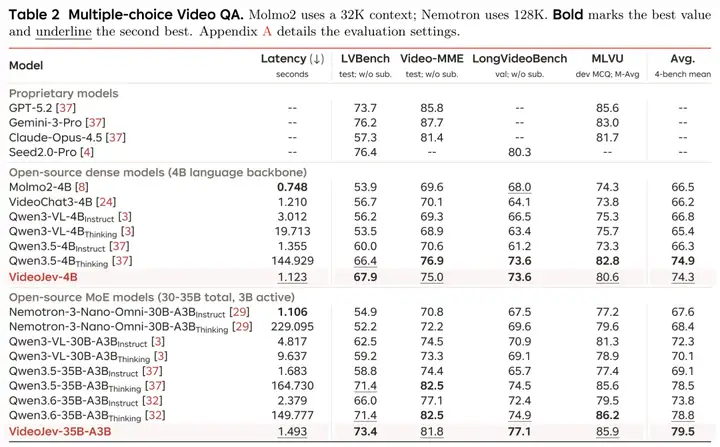
图 1|四个视频问答基准的性能与 LVBench 平均每题耗时,采用论文原表。
两种尺寸都在各自开源模型分组中取得了最高的 LVBench 准确率;35B-A3B 还取得该分组最高的四项平均分。对于需要反复检查视频证据的工作流,这意味着每次判断可以用更低的计算开销完成。
测量口径:耗时在 H200、batch size=1 下统计,包含视觉编码、前缀预填充和模型前向计算,按完整 LVBench 测试集的问题数分摊;不含预处理与数据传输。生成式基线同样复用视频前缀。MLVU 报告七项选择任务的 M-Avg,其余三项报告准确率。
时序定位:更快找到视频中的关键片段
视频交互既要判断“发生了什么”,也要确定“发生在什么时候”。VideoJev 在 Charades-STA、ActivityNet Captions 和 QVHighlights 的 TimeLens-Bench 精修标注上评测,将自然语言描述对应到连续时间区间。
VideoJev-4B 的三项平均 mIoU 为 65.3,35B-A3B 为 67.7,较各自基座分别提升 6.7 和 10.8 个百分点。在更严格的时间重叠要求下,两种模型也表现出更好的定位精度。
在完整 Charades 测试集上,两种尺寸的平均每条查询模型计算耗时分别为 0.276 秒与 0.336 秒,相较各自 Instruct 基座分别加速约 2.8 倍与 3.1 倍。
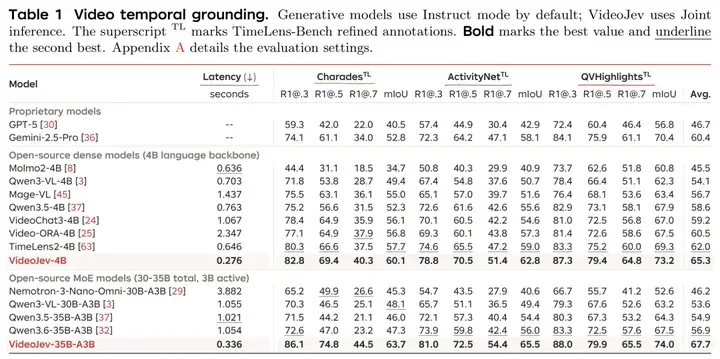
图 2|视频时序定位结果。TL 表示 TimeLens-Bench 精修标注;耗时统计口径同前。
定位精度和计算效率共同决定了视频工具的交互体验:当用户不断提出新的事件描述时,系统既需要返回贴合事件边界的片段,也需要控制每次查询的等待时间。
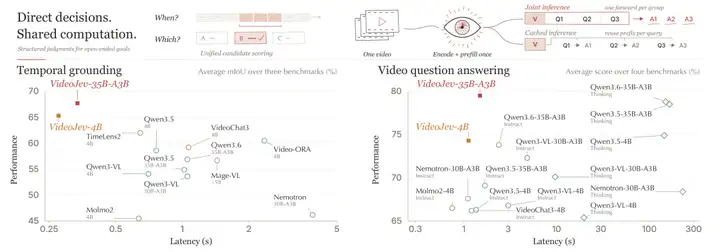
图 3|VideoJev 总览:共享候选打分与视频计算,以及两个任务上的性能—耗时对比。
统一决策框架:为时间区间和答案选项打分
VideoJev 的核心是把两项任务都表述为同一个问题:给定视频和语言查询,哪些候选项最符合视频证据?候选项可以是时间区间,也可以是文字答案。模型用共享的打分头评估它们,再按任务规则生成最终结果。
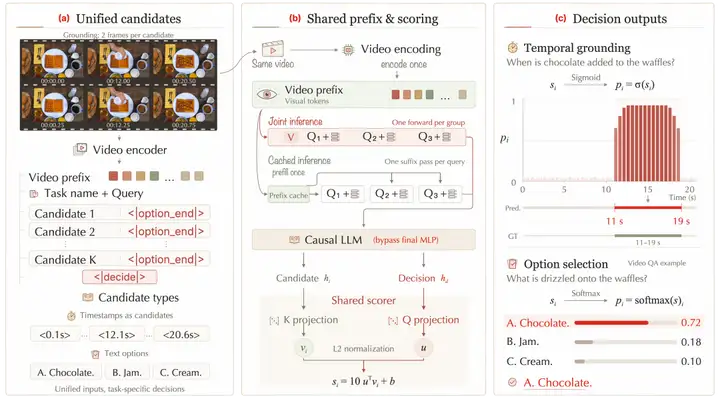
图 4|VideoJev 的输入组织、共享打分与输出方式。图中分数和时间区间为示意。
时间区间是候选,定位是连续片段
对于“什么时候把巧克力淋到华夫饼上”这样的查询,模型判断各个时间区间是否属于目标事件,再将得分解码为一个连续片段。它学习的是视频证据与事件描述之间的对应关系。
文字选项是候选,问答是证据匹配
对于“华夫饼上淋了什么”的问题,模型直接比较“巧克力、果酱、奶油”等选项,输出各自的概率并选择最高分答案。两项任务共享预训练多模态表示和评分架构,各自保留适合任务的监督与输出规则。实现上,VideoJev 基于 Qwen3.5-4B 和 Qwen3.6-35B-A3B 改造:移除最终 MLP,以候选打分头替代语言模型输出头。先对齐新打分头,再联合适配语言主干;视觉编码器保持冻结。整个决策过程无需自回归生成答案。
同一段视频,多个问题,一次前向计算
读入长视频通常比读取问题更昂贵。视频已经相同,后续查询就应尽量复用这部分计算。VideoJev 围绕共享视频前缀组织训练和推理,提供两种方式。
Joint inference:问题一起到,一次处理
将完整视频前缀与同一组中的多个问题、各自候选项拼接成 一个 sequence。模型只需 一次 causal forward pass,就能分别得到这一组问题的候选分数。多个查询可以混合包含时序定位和视频选择问答。
一个视频前缀 → 问题 1 + 候选 → 问题 2 + 候选 → 问题 3 + 候选
一次前向计算,分别输出每个问题的结构化判断。
Cached inference:问题陆续到,继续复用视频
先完成视频编码与前缀预填充;新问题到来后,复用已有视频缓存,只计算新的查询部分。这种组织方式适合围绕同一段视觉历史连续提问。
让快速判断成为视频应用的基础能力
当“是否发生、发生在哪、哪个选项成立”都能以低开销返回,VideoJev 可以成为更复杂视频应用中的判断模块。视频检索与剪辑。围绕同一素材提出多条事件描述,快速定位候选片段,帮助构建按事件检索、素材整理和高光筛选工具。流程检查与交互式助手。针对教学、烹饪或装配视频,把操作步骤转换为具体事件和候选状态,定位关键动作,并回答围绕同一过程的多个问题。视觉 Agent 的快速决策模块。由上层模型拆解目标、提出候选动作或状态,VideoJev 根据视频证据进行判断,再把结果交给规划与执行模块。System Two 组织决策空间,System One 评估视觉证据。
这些方向建立在本文已验证的时序定位与选择问答能力之上。面向持续到来的视频流,增量视觉编码、记忆管理和置信度校准仍是后续研究方向。
本地使用
VideoJev 提供 4B 稠密模型与 35B-A3B MoE 模型,后者约 35B 总参数、约 3B 激活参数。权重以 BF16、Safetensors 格式发布,配套核心训练、评测和推理代码,开发者可以根据算力条件选择合适尺寸。
从魔搭下载模型
pip install -U modelscope
from modelscope import snapshot_download

model_dir = snapshot_download(
    "MCG-NJU/VideoJev-4B",
    local_dir="./VideoJev-4B",
)
下载 35B-A3B 时,将模型 ID 替换为 MCG-NJU/VideoJev-35B-A3B。随后按 GitHub README 安装推理依赖,即可通过 AutoModel、AutoProcessor 和 predict_video 接口运行示例。
输出可以直接接入应用
公开的 10 秒示例视频中,一次调用同时提交定位和选择问答:4B 模型将“穿绿色衣服的女士吃意面”定位到 [3.0, 10.0] 秒,并在问答中选择 “A. Pasta.”。接口同时返回候选概率,便于下游程序消费。
示例默认以 fps=2.0、max_frames=2048 读取视频;时序定位默认 threshold=0.25,支持通过参数调整。完整调用与真实输出见仓库 Quick start。
代码与使用示例:https://github.com/MCG-NJU/VideoJev#quick-start论文:https://arxiv.org/abs/2610.18615
项目主页与演示:https://mcg-nju.github.io/VideoJev
将视频证据转化为可复用的快速判断。
VideoJev 为视频理解和交互提供了统一的 System One 接口,也为更复杂的视觉工作流提供了可以组合的决策能力。
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐


 0
 0
- 0


 已为社区贡献1118条内容

所有评论(0)