电信开源 TeleOCR:1.2B 参数文档解析模型,登顶 OmniDocBench v1.6 榜单
中国电信星辰通用人工智能实验室开源文档解析模型 TeleOCR。该模型采用约 1.2B 参数的轻量级视觉语言架构,在单一框架内统一处理数字文档与相机拍摄文档,并将文字、版面、表格、公式和科学图表转换为可直接使用的结构化结果。
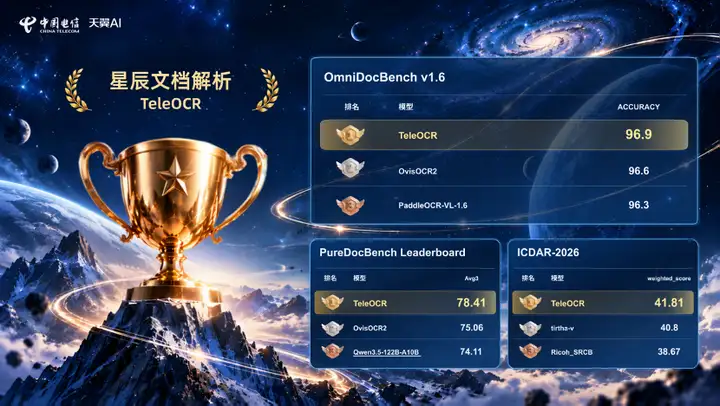
TeleOCR 在 OmniDocBench v1.6 取得 96.87 总分,登顶 OmniDocBench v1.6 榜单,超越 MinerU2.5-Pro、PaddleOCR-VL-1.6、OvisOCR2 等同类专业模型。此外,TeleOCR 同步拿下 PureDocBench 榜首,同时获得文档权威赛事 ICDAR-2026 科学图解析挑战赛冠军。
开源地址:
- 模型链接:https://www.modelscope.cn/models/XingChen-AGI/TeleOCR
- 代码仓库:https://github.com/caipeng328/TeleOCR
- 技术报告:https://arxiv.org/abs/2608.12898
- 在线体验:https://www.teleai.com.cn/docparse/documentParsing
基准测试指标
星辰文档解析模型 TeleOCR 在多项能力测试中均取得亮眼成绩,直接看它的指标:
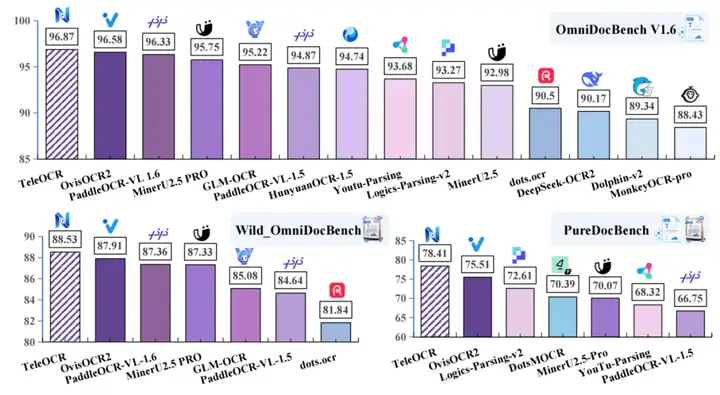
- 在数字文档解析方面:TeleOCR 在 OmniDocBench V1.6 的文本识别(97.22)、表格解析 TEDS(97.05)和公式 CDM(96.36)上表现突出。其中,表格解析 TEDS(97.05)超越 OvisOCR2(94.8)、PaddleOCR-VL 1.6(94.76),大幅超过 MinerU2.5-Pro(93.42);文本识别(97.22)同时超过 PaddleOCR-VL 1.6(96.7)和 MinerU2.5-Pro(96.4)。
- 在真实文档解析方面:TeleOCR 在 Wild-OmniDocBench 的文本识别(88.3)、表格解析 TEDS(89.05)和公式 CDM(88.26)上展现出较强表现。其中,Wild-OmniDocBench 表格解析 TEDS(89.05)超过 OvisOCR2(85.13)和 PaddleOCR-VL 1.6(81.31),公式 CDM(88.26)同时超过 MinerU2.5-Pro(85.0)和 GLM-OCR(79.7)。
- 在多场景综合解析方面:TeleOCR 在 PureDocBench 的 Clean(86.90)、Digital Degraded(77.47)和 Real Degraded(70.85)上表现突出。其中,Clean(86.90)超过 OvisOCR2(81.55)和 FD-RL(78.38),Real Degraded(70.85)同时超过 OvisOCR2(66.56)和 Logics-Parsing-v2(67.64)。
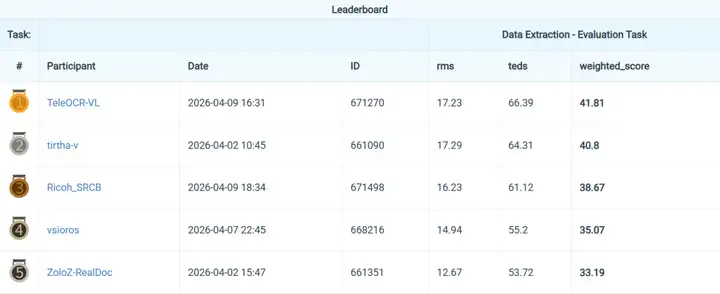
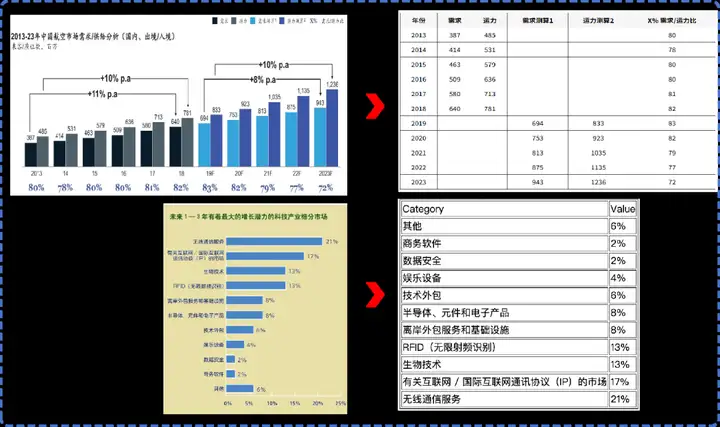
在各类文档解析能力中,科学图解析是难度最高的能力之一,涉及图表元素识别、数据提取与逻辑理解等多重挑战。针对这一难点,星辰文档解析模型 TeleOCR 开展了专项优化,最终凭借总分 41.81 的成绩,夺得文档权威赛事 ICDAR-2026 科学图解析挑战赛冠军。
场景实测效果
星辰文档解析模型 TeleOCR 在场景实测中同样表现优异,直接看它的效果:
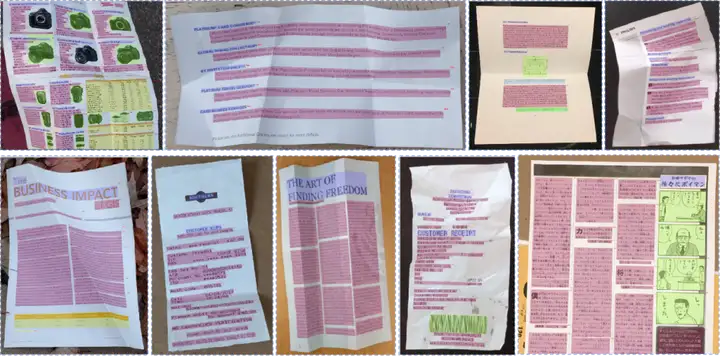
- 复杂拍摄文档:感知文档区域的几何形变,精准恢复扭曲区域的空间位置。
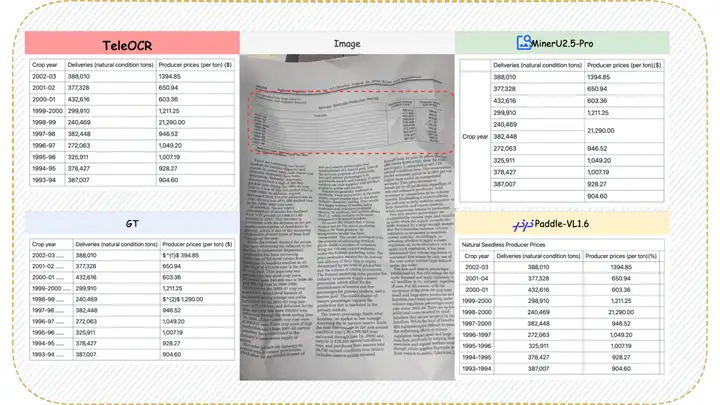
- 复杂表格:精确还原跨行跨列、单元格合并的复杂表格,行列表系不乱、不串位。
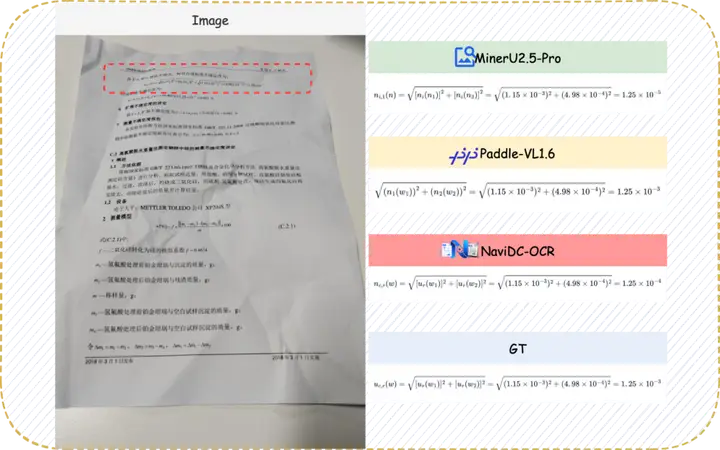
- 复杂扭曲表格公式:结构化解析公式语义与语法结构,实现公式的符号级准确恢复。
除此以外,星辰文档解析模型 TeleOCR 还可以直接提取论文里的图柱状图数据,并转换成结构化表格——这正是拿下 ICDAR 2026 科学图解析冠军的能力。
从识别文字到恢复结构
传统 OCR 主要完成“图像转文字”,但企业文档处理通常还需要回答三个问题:文字位于哪里、不同元素之间是什么关系、如何恢复为可计算的结构。合同、档案、科研论文和业务表单中常见的跨行跨列表格、复杂公式与科学图表,都要求模型同时理解局部字符、全局布局和语义组织。
这一问题在相机拍摄文档中更复杂。透视畸变、页面弯曲、旋转偏移、阴影和运动模糊会破坏版面逻辑,使依赖版面检测、图像校正和识别模块串联的传统流程容易产生误差累积。
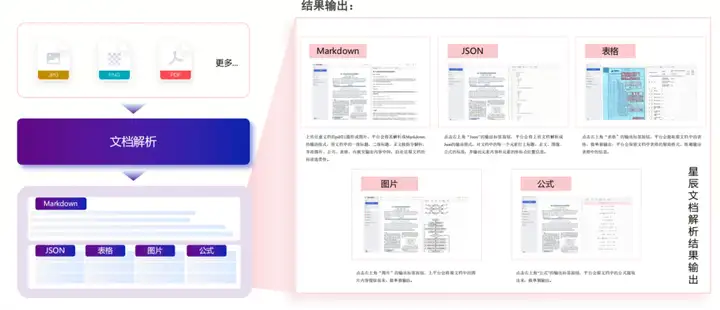
TeleOCR 将数字文档与拍摄文档放入统一框架,直接完成版面与内容解析,无需额外部署独立的去畸变模型。输出可生成为 Markdown、JSON、表格和公式等结构化形式,便于继续接入知识检索、智能问答和业务自动化系统。
数据工程:让训练数据形成闭环
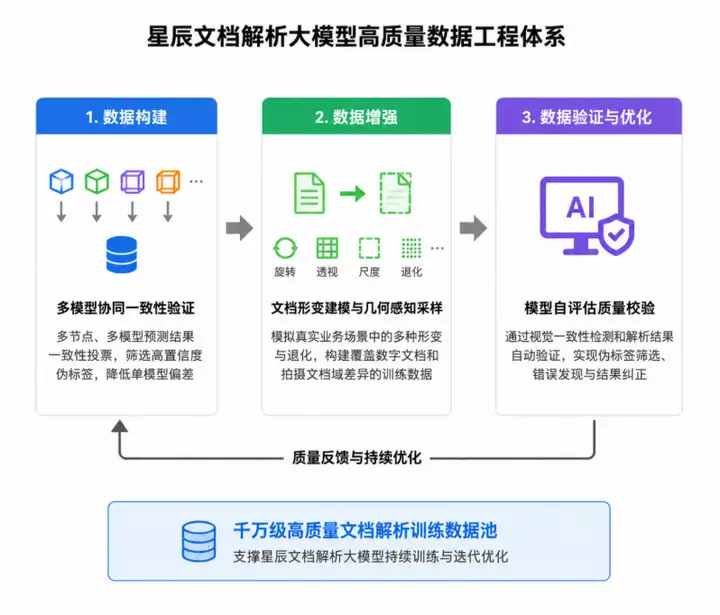
TeleOCR 的数据工程覆盖数据生成、清洗、质量评估与持续优化。核心由多节点共识投票、几何感知数据合成、图像到图像自验证和渐进式数据清洗组成。原始材料显示,该体系已形成千万级文档解析训练数据池,其中大部分生成数据不依赖人工标注。
多节点共识投票(MCV):不同模型对同一文档并行预测,再通过一致性投票筛选高置信度伪标签,降低单一模型偏差对训练数据的影响。
几何感知数据合成:围绕旋转、透视畸变、尺度变化、页面弯曲与图像退化构造样本,让数字文档与真实拍摄文档在同一训练体系中完成对齐。
图像到图像自验证:模型将解析结果重新渲染,并比较视觉一致性,用于自动发现错误、筛选噪声和修正伪标签。
渐进式数据清洗:高一致性结果进入训练集,高分歧样本作为难例继续优化,形成“投票筛选—模型自训练”的数据闭环。
渐进式训练:结构与内容分别学,再联合对齐
TeleOCR 采用四阶段渐进式训练流程:先完成视觉语言对齐,再学习几何感知文档解析,随后进行内容—结构解耦学习,最后进入强化学习阶段。训练目标由基础感知逐步过渡到精细的文档内容与结构理解。
以表格任务为例,TeleOCR 构建两类互补数据。Structure-only 数据通过掩码去除文本,仅保留表格拓扑,强化模型对行列关系和跨行跨列结构的理解;Structure + Content 数据保留完整语义,使模型进一步完成结构与内容的联合对齐。
公式任务同样通过内容—结构解耦学习其语义与语法组织。
针对不规则页面形变,TeleOCR 引入几何感知建模与曲率引导的 Douglas-Peucker 采样(CGDP),显式学习文档边界和空间结构。模型因此能直接处理弯曲、折叠和透视畸变页面,而无需将去畸变作为独立前置步骤。、
本地部署与推理
TeleOCR 需要 Python 3.10 及以上版本,并需要支持 CUDA 的 GPU 环境。官方仓库提供 infer.py,支持批量处理图片,并可在 vllm-engine 与 vllm-async-engine 两种后端之间切换。
先拉取代码并安装依赖:
git clone https://github.com/caipeng328/TeleOCR.git
cd TeleOCR
conda create -n teleocr python=3.10 -y
conda activate teleocr
pip install -e .
从魔搭社区下载模型权重:
pip install modelscope
modelscope download --model XingChen-AGI/TeleOCR \
  --local_dir ./models/TeleOCR
准备输入与输出目录后运行批量推理:
IMAGE_SUB_PATH="/path/to/input/images"
RESULT_SAVE_PATH="/path/to/output/results"

python infer.py \
  --image_sub_path "${IMAGE_SUB_PATH}" \
  --result_save_path "${RESULT_SAVE_PATH}" \
  --use_async \
  --override \
  model_path="./models/TeleOCR" \
  BACKEND="vllm-async-engine" \
  LAYOUT_MODE="Detection"
LAYOUT_MODE="Detection" 适合常规数字文档;处理弯曲、折叠或其他真实退化页面时,可切换为 LAYOUT_MODE="Segmentation"。
MAX_MODEL_LEN、GPU_MEMORY_UTILIZATION、PDF_TOOLS 和 MAX_PIXELS 等参数可分别控制上下文长度、显存占用、PDF 处理后端与单页最大像素数。
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1100条内容

所有评论(0)