电信开源Xing4.0-29B-A4B:29B MoE 激活仅 4B,单卡显存仅约 15GB
近日,中电信人工智能科技有限公司正式发布 Xing4.0-29B-A4B——面向智能体时代的新一代星辰大模型。这是一款总参数量 29B、激活参数仅 4B 的 MoE 智能体大模型,原生支持 256K 上下文,可扩展至 512K,是国内首个基于国产算力与国产框架完成训练、面向复杂工程任务深度优化的百亿参数大模型。
作为新一代星辰大模型,Xing4.0 在 TeleChat1-3 系列基础上全面升级,从模型架构、训练 Infra 到能力范式实现全面跃迁。如果说此前 TeleChat1-3 系列大模型更多解决的是“你问我,我回答”,那么 Xing4.0 系列大模型要解决的,是“你给我一个目标,我帮你把事情做完”。Xing4.0 正在推动星辰系列大模型从“会回答”走向“会做事”。这不仅是一次模型版本的迭代,更是星辰大模型一次能力范式的跃迁。
面向 Agent 场景对模型理解、规划与执行能力提出的新需求,Xing4.0-29B-A4B 采用 mHC+MLA+MTP 架构设计,可高效处理长程 Agent 任务,支持多步骤规划、工具调用和复杂推理链路执行,保障长会话上下文下任务逻辑连贯、执行稳定。
通过 4-bit 量化技术,模型将单卡显存占用降低至约 15GB,相比 FP16 方案降低约 75%,在 RTX 3090、RTX 4090 等 24GB 显存消费级 GPU 上即可支持本地运行长上下文任务。
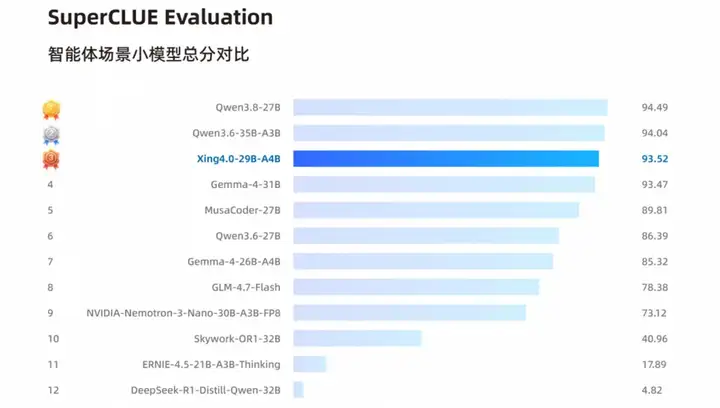
在性能表现上,模型在 SWE-bench Verified 取得 75.0,在 SuperCLUE 智能体能力评测中得分 93.52、位列第 3 名。
ModelScope:
https://modelscope.cn/models/XingChen-AGI/Xing4.0-29B-A4B
Github:
https://github.com/XingChen-AGI/Xing4.0-29B-A4B
性能表现
编码 Agent
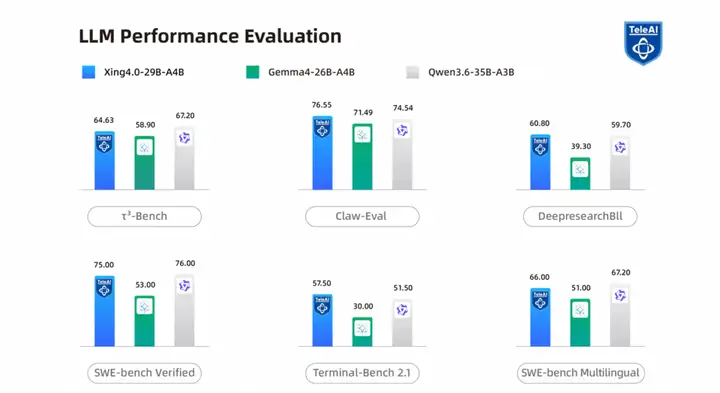
在编码 Agent 方面,Xing4.0-29B-A4B 在 SWE-bench Verified(75.0)、SWE-bench Multilingual(66.0)和 Terminal-Bench 2.1(57.5)上表现突出。
其中,SWE-bench Verified(75.0)接近 Qwen3.6-35B-A3B(76.0),大幅超过 Gemma4-26B-A4B(53.0);Terminal-Bench 2.1(57.5)同时超过 Qwen3.6-35B-A3B(51.5)和 Gemma4-26B-A4B(30.0)。
通用 Agent
在通用 Agent 方面,Xing4.0-29B-A4B 在 Claw-Eval(76.55)、DeepresearchBII(60.80)和 τ³-Bench(64.63)上展现出较强表现。
其中,Claw-Eval(76.55)超过 Qwen3.6-35B-A3B(74.54)和 Gemma4-26B-A4B(71.49),DeepresearchBII(60.80)也超过 Qwen3.6-35B-A3B(59.70)和 Gemma4-26B-A4B(39.30)。
以上是针对智能体场景小尺寸模型对比结果。从 SuperCLUE 评测结果来看,在智能体能力方面,Xing4.0-29B-A4B 得分 93.52,位列第 3 名,与两款头部 Qwen 模型的差距均不足 1 分。综合来看,Xing4.0-29B-A4B 在较小参数规模下实现了较强的智能体能力,在任务规划、工具调用、代码处理和端到端任务执行等方面表现突出,为数据处理、办公自动化等智能体应用提供了良好的模型基础。
模型架构与训练
架构设计
面向长程 Agent 任务进行模型架构创新,引入 MLA 多头潜变量注意力压缩 KV 缓存,MTP 多 Token 预测增强生成连贯性,mHC 流形约束超连接改善深层网络训练稳定性,并结合 Muon + QK-Clip 优化器提升训练稳定性。
训练采用分阶段递进策略,序列长度从 4K 逐步扩展至 32K、128K、256K,系统性构建长程上下文能力。
训练 Infra
基于昇腾 910C 集群开展新一代模型架构与国产算力协同优化,实现“国芯训国模”。针对 mHC 多残差连接,基于 MindSpore/MindFormers 完成特性适配、跨框架精度对齐及融合算子开发;针对 64 路由专家、Top4 激活的细粒度 MoE,围绕专家负载均衡、Grouped GEMM、共享专家计算与 All-to-All 通信重叠进行优化,并结合 DVM 图算自动融合,降低通信长尾与碎片化算子开销;进一步采用层级 + 算子级选择性重计算,以及 Ascend C 定制 mHC 融合算子,持续提升计算与显存效率。经过模型架构、编译、算子与硬件的多层次协同,整网训练吞吐较开箱性能提升约 96%,接近翻倍。
多专家强化学习
依托昇腾生态完成 Slime 强化学习框架适配,面向 Agent、Coding、Reasoning 等复杂任务开展多专家强化学习训练,并通过 MOPD 技术实现多专家能力高效融合,进一步强化复杂推理、长程任务规划与工具协同能力。
通过模型架构、训练 Infra 与强化学习三个层面的协同攻坚,Xing4.0-29B-A4B 打通从模型架构适配、国产算力训练到强化学习能力增强的完整技术链路,实现模型与国产芯片、国产框架的深度融合,形成“国芯训国模”的新路径。
轻量化工程化部署
Xing4.0-29B-A4B 通过 4-bit 量化技术,将单卡显存占用降低至约 15GB,相比 FP16 方案降低约 75%。在 RTX 3090、RTX 4090 等 24GB 显存消费级 GPU 上,即可支持本地运行长上下文任务,推理吞吐达到约 30 tokens/s,满足开发者进行 Agent 应用开发和本地部署需求。
这意味着个人开发者、小型工作室、中小企业不用采购昂贵的 A 系列专业卡,依托现有消费级硬件就能本地跑起模型。既能完成复杂任务拆解、工具调用执行,也能保证数据安全私密。
开源生态兼容
主流开源生态兼容
Xing4.0-29B-A4B 延续星辰大模型的开源路线,支持 LLaMA-Factory、Mindformers 等微调框架,适配 SGLang、vLLM、KTransformers 等主流推理框架。无论是模型微调还是生产环境部署,开发者均可沿用熟悉的开源工具链,无需额外学习成本,实现便捷高效的全链路落地。
Agent 框架无缝接入
模型针对 OpenCode、Claude Code、OpenClaw、Hermes 等主流 Agent 与代码框架做定向适配调优,深度对齐各框架格式规范。这意味着,开发者无需繁琐的集成改造,即可将 Xing4.0-29B-A4B 无缝接入现有开发工作流,大幅降低框架适配成本。
FlagOS 跨芯统一适配
基于北京智源人工智能研究院 FlagOS 统一开源 AI 软件栈,Xing4.0-29B-A4B 已在昇腾、沐曦、摩尔线程、平头哥、海光等多家国产芯片跨芯适配、精度对齐与部署验证,适配镜像已上线魔搭,提供开箱即用部署方案。
此外,FlagOS 技术栈为 Xing4.0-29B 提供了统一支持多种 AI 芯片的推理插件,包括 vLLM-plugin-FL 和 SGLang-plugin-FL 两种推理框架插件。依托 FlagOS 的异构抽象层与统一运行时,模型可实现跨芯片架构的无缝迁移与一键部署,真正打破算力边界,让异构多元算力开箱即用。
典型业务应用场景
1. 数据不出域,表格能读懂
面对承载核心机密的财务报表、经营数据等复杂表格,Xing4.0-29B-A4B 支持私有化部署,数据全程不出域。模型能够理解表格结构与分析需求,自动生成数据处理、统计分析代码并调用执行,快速完成指标提取、异常识别、复杂指标计算等任务。
2. 复杂任务,自主拆解执行
一份典型的投标文件动辄数百页乃至上千页,涵盖技术规格、商务条款、法律承诺及海量财务数据,以文本、图表、图纸等非结构化形态交织呈现。Xing4.0-29B-A4B 能够自主拆解评审任务,规划执行路径,调用文档解析、检索、代码执行等工具,完成信息提取、内容比对与结果汇总,让复杂任务从“人工处理”走向“自主执行”。
面对复杂的企业选型对比需求,模型可以将复杂需求拆解为 12 步闭环可执行链路,每一步精准匹配对应工具。
3. 一句需求,自动生成应用
面对 Excel、数据库等业务数据,Xing4.0-29B-A4B 能够理解业务需求,自动生成数据处理、分析及前端可视化代码,并调用执行环境进行验证与迭代,将复杂业务数据快速转化为合同管控大屏,实现合同概览、金额分析、风险识别、履约预警等功能。借超强的代码生成、场景适配能力,模型还可以零代码、一句话生成可直接运行的趣味教学 Web 页面。
4. 发现问题,自动编程排障
面对系统日志、报错信息和业务异常,Xing4.0-29B-A4B 能够自主分析问题、生成排障代码、调用工具获取数据并执行验证,根据执行结果持续调整分析路径,推动任务从问题发现、原因定位到结果验证,提升复杂问题的排障效率。
5. 客服智能体:端到端秒级响应,复杂业务自主办理
智能客服场景,尤其运营商客服热线,涵盖套餐变更、账单查询、故障报修等数十类高频业务,数据隐私、任务复杂度和实时响应要求极高。模型以三项能力精准匹配:
- 隐私安全可控:模型总参数量 29B、激活参数仅 4B,硬件资源占用低,可在本地环境独立运行,确保用户通话数据、身份信息及业务记录全程不出域,满足核心生产系统的合规要求。
- 复杂任务自主闭环:模型具备多步自主规划与深度推理能力,可协同调度外部工具链及多个下游子智能体,构建“意图理解→任务拆解→工具调用→结果整合→合规校验”的完整闭环。面对模糊意图与多轮交叉诉求,动态调度业务办理、风控校验等子智能体协同作业,实现从简单问答到复杂业务自助办理的跨越。
- 端到端秒级响应:基于稀疏激活架构,模型在保障业务效果的同时实现极致推理效率,端到端首 Token 响应时延压降明显,充分满足热线实时通话对低时延、高并发的严苛要求,保障用户“边说边响应”的流畅体验。
模型下载与推理
Xing4.0-29B-A4B 支持 Transformers 本地推理,并已向 vLLM、SGLang、TensorRT-LLM、llama.cpp 和KTransformers 5 个服务化推理框架提交适配 PR。
目前相关 PR 尚待合入上游主分支,本节重点介绍官方已提供启动示例的 vLLM、SGLang 和 KTransformers。复杂推理与通用任务推荐设置 temperature=1.0、top_p=0.95、repetition_penalty=1.05;代码与智能体任务可将 temperature 调整为 0.8。
模型下载
pip install -U modelscope
modelscope download --model XingChen-AGI/Xing4.0-29B-A4B --local_dir XingChen-AGI/Xing4.0-29B-A4B
export MODEL_PATH="XingChen-AGI/Xing4.0-29B-A4B"
通过 Transformers推理
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
path = "XingChen-AGI/Xing4.0-29B-A4B"
tokenizer = AutoTokenizer.from_pretrained(path, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(path, trust_remote_code=True, device_map="auto", dtype=torch.bfloat16)
prompt = "Briefly explain the basic principles of quantum computing."
messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
model_inputs = tokenizer(text, return_tensors="pt").to(model.device)
generated_ids = model.generate(
    **model_inputs,
    top_p=0.95,
    temperature=1.0,
    repetition_penalty=1.05,
    max_new_tokens=32768
)
response = tokenizer.decode(generated_ids[0], skip_special_tokens=False, spaces_between_special_tokens=False)
# The model output contains a Chain-of-Thought; the final answer follows </think>
answer = response.split("</think>")[-1].strip()
print(answer)
模型输出包含思考过程,最终回答位于 </think> 标记之后。
vLLM 部署
vllm serve ${MODEL_PATH} \
  --host 0.0.0.0 \
  --port 8000 \
  --served-model-name Xing4.0-29B-A4B \
  --tensor-parallel-size 2 \
  --trust-remote-code \
  --max-model-len 262144 \
  --gpu-memory-utilization 0.90 \
  --max-num-seqs 32 \
  --reasoning-parser xing4 \
  --tool-call-parser xing4 \
  --speculative-config '{"method":"mtp", "num_speculative_tokens": 1}'
服务启动后,可通过 http://localhost:8000/v1 调用 OpenAI 兼容 API。
vLLM 适配PR:https://github.com/vllm-project/vllm/pull/57135
SGLang 部署
sglang serve --model-path ${MODEL_PATH} \
  --trust-remote-code \
  --host 0.0.0.0 \
  --port 8000 \
  --served-model-name Xing4.0-29B-A4B \
  --tp-size 2 \
  --context-length 262144 \
  --mem-fraction-static 0.90 \
  --max-running-requests 32 \
  --reasoning-parser xing4 \
  --tool-call-parser xing4 \
  --speculative-algorithm EAGLE
服务启动后,同样可通过 http://localhost:8000/v1 访问。
SGLang 适配 PR:https://github.com/sgl-project/sglang/pull/39793
KTransformers 部署
KTransformers 支持通过 GPU 与 CPU 异构计算,在有限 GPU 资源下运行 MoE 模型。
python -m sglang.launch_server \
  --host 0.0.0.0 \
  --port 30000 \
  --model-path ${MODEL_PATH} \
  --served-model-name Xing4.0-29B-A4B \
  --tensor-parallel-size 1 \
  --trust-remote-code \
  --attention-backend triton \
  --kt-weight-path ${MODEL_PATH} \
  --kt-method BF16 \
  --kt-cpuinfer 50 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 24 \
  --mem-fraction-static 0.9 \
  --chunked-prefill-size 512 \
  --max-total-tokens 65536 \
  --tool-call-parser xing4_0 \
  --reasoning-parser xing4_0
KTransformers 适配 PR:https://github.com/kvcache-ai/ktransformers/pull/2168
OpenAI 兼容 API 调用
以下以 vLLM/SGLang 服务为例,通过 OpenAI 兼容 API 调用模型;使用 KTransformers 时,将端口调整为 30000。
from openai import OpenAI
client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",
)
completion = client.chat.completions.create(
    model="Xing4.0-29B-A4B",
    messages=[{"role": "user", "content": "简要介绍量子计算的基本原理。"}],
    temperature=1.0,
    top_p=0.95,
    extra_body={
        "repetition_penalty": 1.05,
        "skip_special_tokens": False,
        "spaces_between_special_tokens": False,
        "chat_template_kwargs": {
            "enable_thinking": True,  # 设置为 False 可关闭思考过程
        },
    },
)
print(completion.choices[0].message.content)
其他框架适配进展
- TensorRT-LLM:https://github.com/NVIDIA/TensorRT-LLM/pull/19283
- llama.cpp:https://github.com/ggml-org/llama.cpp/pull/29012
ModelScope旨在打造下一代开源的模型即服务共享平台,为泛AI开发者提供灵活、易用、低成本的一站式模型服务产品,让模型应用更简单!
更多推荐
 0
 0
- 0


 已为社区贡献1094条内容

所有评论(0)